


Commit ·
087d515
0
Parent(s):
Duplicate from arcee-ai/AFM-4.5B-Base
Browse filesCo-authored-by: Bartowski <bartowski@users.noreply.huggingface.co>
- .gitattributes +36 -0
- README.md +90 -0
- config.json +36 -0
- model-00001-of-00002.safetensors +3 -0
- model-00002-of-00002.safetensors +3 -0
- model.safetensors.index.json +1 -0
- special_tokens_map.json +16 -0
- tokenizer.json +3 -0
- tokenizer_config.json +46 -0
.gitattributes
ADDED
|
@@ -0,0 +1,36 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
*.7z filter=lfs diff=lfs merge=lfs -text
|
| 2 |
+
*.arrow filter=lfs diff=lfs merge=lfs -text
|
| 3 |
+
*.bin filter=lfs diff=lfs merge=lfs -text
|
| 4 |
+
*.bz2 filter=lfs diff=lfs merge=lfs -text
|
| 5 |
+
*.ckpt filter=lfs diff=lfs merge=lfs -text
|
| 6 |
+
*.ftz filter=lfs diff=lfs merge=lfs -text
|
| 7 |
+
*.gz filter=lfs diff=lfs merge=lfs -text
|
| 8 |
+
*.h5 filter=lfs diff=lfs merge=lfs -text
|
| 9 |
+
*.joblib filter=lfs diff=lfs merge=lfs -text
|
| 10 |
+
*.lfs.* filter=lfs diff=lfs merge=lfs -text
|
| 11 |
+
*.mlmodel filter=lfs diff=lfs merge=lfs -text
|
| 12 |
+
*.model filter=lfs diff=lfs merge=lfs -text
|
| 13 |
+
*.msgpack filter=lfs diff=lfs merge=lfs -text
|
| 14 |
+
*.npy filter=lfs diff=lfs merge=lfs -text
|
| 15 |
+
*.npz filter=lfs diff=lfs merge=lfs -text
|
| 16 |
+
*.onnx filter=lfs diff=lfs merge=lfs -text
|
| 17 |
+
*.ot filter=lfs diff=lfs merge=lfs -text
|
| 18 |
+
*.parquet filter=lfs diff=lfs merge=lfs -text
|
| 19 |
+
*.pb filter=lfs diff=lfs merge=lfs -text
|
| 20 |
+
*.pickle filter=lfs diff=lfs merge=lfs -text
|
| 21 |
+
*.pkl filter=lfs diff=lfs merge=lfs -text
|
| 22 |
+
*.pt filter=lfs diff=lfs merge=lfs -text
|
| 23 |
+
*.pth filter=lfs diff=lfs merge=lfs -text
|
| 24 |
+
*.rar filter=lfs diff=lfs merge=lfs -text
|
| 25 |
+
*.safetensors filter=lfs diff=lfs merge=lfs -text
|
| 26 |
+
saved_model/**/* filter=lfs diff=lfs merge=lfs -text
|
| 27 |
+
*.tar.* filter=lfs diff=lfs merge=lfs -text
|
| 28 |
+
*.tar filter=lfs diff=lfs merge=lfs -text
|
| 29 |
+
*.tflite filter=lfs diff=lfs merge=lfs -text
|
| 30 |
+
*.tgz filter=lfs diff=lfs merge=lfs -text
|
| 31 |
+
*.wasm filter=lfs diff=lfs merge=lfs -text
|
| 32 |
+
*.xz filter=lfs diff=lfs merge=lfs -text
|
| 33 |
+
*.zip filter=lfs diff=lfs merge=lfs -text
|
| 34 |
+
*.zst filter=lfs diff=lfs merge=lfs -text
|
| 35 |
+
*tfevents* filter=lfs diff=lfs merge=lfs -text
|
| 36 |
+
tokenizer.json filter=lfs diff=lfs merge=lfs -text
|
README.md
ADDED
|
@@ -0,0 +1,90 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
---
|
| 2 |
+
license: apache-2.0
|
| 3 |
+
language:
|
| 4 |
+
- en
|
| 5 |
+
- es
|
| 6 |
+
- fr
|
| 7 |
+
- de
|
| 8 |
+
- it
|
| 9 |
+
- pt
|
| 10 |
+
- ru
|
| 11 |
+
- ar
|
| 12 |
+
- hi
|
| 13 |
+
- ko
|
| 14 |
+
- zh
|
| 15 |
+
library_name: transformers
|
| 16 |
+
extra_gated_prompt: Company name is optional, please put NA if you would prefer not to share it.
|
| 17 |
+
---
|
| 18 |
+
|
| 19 |
+
<div align="center">
|
| 20 |
+
<picture>
|
| 21 |
+
<img src="https://cdn-uploads.huggingface.co/production/uploads/6435718aaaef013d1aec3b8b/Lj9YVLIKKdImV_jID0A1g.png" width="25%" alt="Arcee AFM 4.5B">
|
| 22 |
+
</picture>
|
| 23 |
+
</div>
|
| 24 |
+
|
| 25 |
+
# AFM-4.5B-Base
|
| 26 |
+
|
| 27 |
+
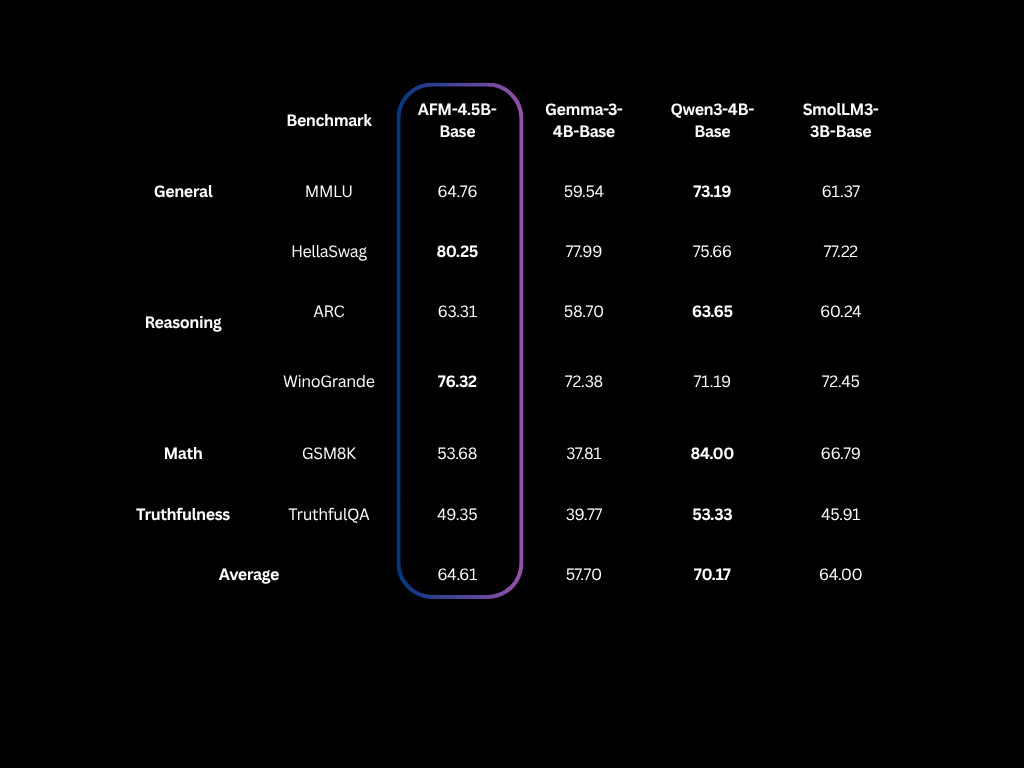
**AFM-4.5B-Base** is a 4.5 billion parameter instruction-tuned model developed by Arcee.ai, designed for enterprise-grade performance across diverse deployment environments from cloud to edge. The base model was trained on a dataset of 8 trillion tokens, comprising 6.5 trillion tokens of general pretraining data followed by 1.5 trillion tokens of midtraining data with enhanced focus on mathematical reasoning and code generation. Following pretraining, the model underwent supervised fine-tuning on high-quality instruction datasets. The instruction-tuned model was further refined through reinforcement learning on verifiable rewards as well as for human preference. We use a modified version of [TorchTitan](https://arxiv.org/abs/2410.06511) for pretraining, [Axolotl](https://axolotl.ai) for supervised fine-tuning, and a modified version of [Verifiers](https://github.com/willccbb/verifiers) for reinforcement learning.
|
| 28 |
+
|
| 29 |
+
The development of AFM-4.5B prioritized data quality as a fundamental requirement for achieving robust model performance. We collaborated with DatologyAI, a company specializing in large-scale data curation. DatologyAI's curation pipeline integrates a suite of proprietary algorithms—model-based quality filtering, embedding-based curation, target distribution-matching, source mixing, and synthetic data. Their expertise enabled the creation of a curated dataset tailored to support strong real-world performance.
|
| 30 |
+
|
| 31 |
+
The model architecture follows a standard transformer decoder-only design based on Vaswani et al., incorporating several key modifications for enhanced performance and efficiency. Notable architectural features include grouped query attention for improved inference efficiency and ReLU^2 activation functions instead of SwiGLU to enable sparsification while maintaining or exceeding performance benchmarks.
|
| 32 |
+
|
| 33 |
+
The model available in this repo is the base model following merging and context extension.
|
| 34 |
+
|
| 35 |
+
***
|
| 36 |
+
|
| 37 |
+
<div align="center">
|
| 38 |
+
<picture>
|
| 39 |
+
<img src="https://cdn-uploads.huggingface.co/production/uploads/6435718aaaef013d1aec3b8b/sSVjGNHfrJKmQ6w8I18ek.png" style="background-color:ghostwhite;padding:5px;" width="17%" alt="Powered by Datology">
|
| 40 |
+
</picture>
|
| 41 |
+
</div>
|
| 42 |
+
|
| 43 |
+
## Model Details
|
| 44 |
+
|
| 45 |
+
* **Model Architecture:** ArceeForCausalLM
|
| 46 |
+
* **Parameters:** 4.5B
|
| 47 |
+
* **Training Tokens:** 8T
|
| 48 |
+
* **License:** [Apache-2.0](https://huggingface.co/arcee-ai/AFM-4.5B-Base#license)
|
| 49 |
+
|
| 50 |
+
***
|
| 51 |
+
|
| 52 |
+
## Benchmarks
|
| 53 |
+
|
| 54 |
+
|
| 55 |
+
|
| 56 |
+
## How to use with `transformers`
|
| 57 |
+
|
| 58 |
+
You can use the model directly with the `transformers` library.
|
| 59 |
+
|
| 60 |
+
```python
|
| 61 |
+
from transformers import AutoTokenizer, AutoModelForCausalLM
|
| 62 |
+
import torch
|
| 63 |
+
|
| 64 |
+
model_id = "arcee-ai/AFM-4.5B-Base"
|
| 65 |
+
tokenizer = AutoTokenizer.from_pretrained(model_id)
|
| 66 |
+
model = AutoModelForCausalLM.from_pretrained(
|
| 67 |
+
model_id,
|
| 68 |
+
torch_dtype=torch.bfloat16,
|
| 69 |
+
device_map="auto"
|
| 70 |
+
)
|
| 71 |
+
|
| 72 |
+
prompt = "Once upon a time "
|
| 73 |
+
input_ids = tokenizer(prompt, return_tensors="pt").input_ids.to(model.device)
|
| 74 |
+
|
| 75 |
+
# Generate text
|
| 76 |
+
outputs = model.generate(
|
| 77 |
+
input_ids,
|
| 78 |
+
max_new_tokens=100,
|
| 79 |
+
do_sample=True,
|
| 80 |
+
temperature=0.7,
|
| 81 |
+
top_p=0.95
|
| 82 |
+
)
|
| 83 |
+
|
| 84 |
+
generated_text = tokenizer.batch_decode(outputs, skip_special_tokens=True)[0]
|
| 85 |
+
print(generated_text)
|
| 86 |
+
```
|
| 87 |
+
|
| 88 |
+
## License
|
| 89 |
+
|
| 90 |
+
AFM-4.5B is released under the Apache-2.0 license.
|
config.json
ADDED
|
@@ -0,0 +1,36 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"architectures": [
|
| 3 |
+
"ArceeForCausalLM"
|
| 4 |
+
],
|
| 5 |
+
"attention_bias": false,
|
| 6 |
+
"attention_dropout": 0.0,
|
| 7 |
+
"bos_token_id": 128000,
|
| 8 |
+
"eos_token_id": 128001,
|
| 9 |
+
"head_dim": 128,
|
| 10 |
+
"hidden_act": "relu2",
|
| 11 |
+
"hidden_size": 2560,
|
| 12 |
+
"initializer_range": 0.02,
|
| 13 |
+
"intermediate_size": 18432,
|
| 14 |
+
"max_position_embeddings": 65536,
|
| 15 |
+
"mlp_bias": false,
|
| 16 |
+
"model_type": "arcee",
|
| 17 |
+
"num_attention_heads": 20,
|
| 18 |
+
"num_hidden_layers": 36,
|
| 19 |
+
"num_key_value_heads": 4,
|
| 20 |
+
"rms_norm_eps": 1e-05,
|
| 21 |
+
"rope_scaling": {
|
| 22 |
+
"beta_fast": 32.0,
|
| 23 |
+
"beta_slow": 1.0,
|
| 24 |
+
"factor": 20.0,
|
| 25 |
+
"mscale": 1.0,
|
| 26 |
+
"original_max_position_embeddings": 4096,
|
| 27 |
+
"rope_type": "yarn",
|
| 28 |
+
"type": "yarn"
|
| 29 |
+
},
|
| 30 |
+
"rope_theta": 10000.0,
|
| 31 |
+
"tie_word_embeddings": false,
|
| 32 |
+
"torch_dtype": "bfloat16",
|
| 33 |
+
"transformers_version": "4.53.2",
|
| 34 |
+
"use_cache": false,
|
| 35 |
+
"vocab_size": 128004
|
| 36 |
+
}
|
model-00001-of-00002.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:3571477a89761f392128de1c5b0a636703abe15a1f1d2b9e7823905425f406bc
|
| 3 |
+
size 4965305552
|
model-00002-of-00002.safetensors
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:9f505916ba600c03b1c65298a2f2cd658c5a18245e4e6c733adea1661954c59c
|
| 3 |
+
size 4273097520
|
model.safetensors.index.json
ADDED
|
@@ -0,0 +1 @@
|
|
|
|
|
|
|
| 1 |
+
{"metadata": {"mergekit_version": "0.1.3"}, "weight_map": {"model.layers.0.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.0.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.1.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.0.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.1.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.10.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.1.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.11.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.10.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.12.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.0.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.0.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.0.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.0.self_attn.o_proj.weight": "model-00001-of-00002.safetensors", "model.layers.0.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.11.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.13.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.1.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.1.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.1.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.1.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.1.self_attn.o_proj.weight": "model-00001-of-00002.safetensors", "model.layers.12.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.14.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.10.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.10.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.10.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.10.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.10.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.13.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.15.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.11.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.11.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.11.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.11.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.11.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.14.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.16.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.12.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.12.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.12.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.12.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.12.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.17.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.13.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.13.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.13.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.15.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.13.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.18.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.14.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.13.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.14.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.14.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.16.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.19.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.15.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.14.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.15.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.14.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.15.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.17.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.2.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.16.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.16.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.15.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.15.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.16.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.18.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.20.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.17.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.17.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.16.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.16.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.17.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.19.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.21.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.18.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.18.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.17.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.18.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.17.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.2.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.22.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.19.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.19.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.18.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.19.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.18.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.20.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.23.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.2.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.2.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.19.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.2.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.19.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.21.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.24.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.20.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.20.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.2.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.20.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.2.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.25.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.22.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.21.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.21.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.20.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.21.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.26.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.23.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.22.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.22.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.22.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.20.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.21.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.27.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.24.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.23.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.23.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.23.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.21.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.22.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.28.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.25.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.24.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.24.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.24.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.22.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.23.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.29.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.25.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.26.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.25.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.25.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.23.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.24.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.3.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.26.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.26.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.27.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.26.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.24.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.30.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.27.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.27.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.25.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.28.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.27.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.25.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.31.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.28.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.28.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.26.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.29.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.28.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.32.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.26.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.29.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.29.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.27.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.3.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.29.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.33.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.3.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.27.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.3.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.28.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.30.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.3.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.34.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.30.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.30.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.28.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.29.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.31.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.30.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.35.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.31.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.31.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.29.mlp.down_proj.weight": "model-00001-of-00002.safetensors", "model.layers.3.mlp.up_proj.weight": "model-00001-of-00002.safetensors", "model.layers.32.self_attn.q_proj.weight": "model-00001-of-00002.safetensors", "model.layers.31.self_attn.k_proj.weight": "model-00001-of-00002.safetensors", "model.layers.4.self_attn.v_proj.weight": "model-00001-of-00002.safetensors", "model.layers.32.input_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.32.post_attention_layernorm.weight": "model-00001-of-00002.safetensors", "model.layers.3.mlp.down_proj.weight": "model-00002-of-00002.safetensors", "model.layers.32.self_attn.k_proj.weight": "model-00002-of-00002.safetensors", "model.layers.30.mlp.up_proj.weight": "model-00002-of-00002.safetensors", "model.layers.33.self_attn.q_proj.weight": "model-00002-of-00002.safetensors", "model.layers.5.self_attn.v_proj.weight": "model-00002-of-00002.safetensors", "model.layers.33.input_layernorm.weight": "model-00002-of-00002.safetensors", "model.layers.33.post_attention_layernorm.weight": "model-00002-of-00002.safetensors", "model.layers.30.mlp.down_proj.weight": "model-00002-of-00002.safetensors", "model.layers.31.mlp.up_proj.weight": "model-00002-of-00002.safetensors", "model.layers.33.self_attn.k_proj.weight": "model-00002-of-00002.safetensors", "model.layers.6.self_attn.v_proj.weight": "model-00002-of-00002.safetensors", "model.layers.34.self_attn.q_proj.weight": "model-00002-of-00002.safetensors", "model.layers.34.input_layernorm.weight": "model-00002-of-00002.safetensors", "model.layers.34.post_attention_layernorm.weight": "model-00002-of-00002.safetensors", "model.layers.31.mlp.down_proj.weight": "model-00002-of-00002.safetensors", "model.layers.32.mlp.up_proj.weight": "model-00002-of-00002.safetensors", "model.layers.34.self_attn.k_proj.weight": "model-00002-of-00002.safetensors", "model.layers.7.self_attn.v_proj.weight": "model-00002-of-00002.safetensors", "model.layers.35.self_attn.q_proj.weight": "model-00002-of-00002.safetensors", "model.layers.35.input_layernorm.weight": "model-00002-of-00002.safetensors", "model.layers.35.post_attention_layernorm.weight": "model-00002-of-00002.safetensors", "model.layers.32.mlp.down_proj.weight": "model-00002-of-00002.safetensors", "model.layers.33.mlp.up_proj.weight": "model-00002-of-00002.safetensors", "model.layers.35.self_attn.k_proj.weight": "model-00002-of-00002.safetensors", "model.layers.8.self_attn.v_proj.weight": "model-00002-of-00002.safetensors", "model.layers.4.self_attn.q_proj.weight": "model-00002-of-00002.safetensors", "model.layers.4.input_layernorm.weight": "model-00002-of-00002.safetensors", "model.layers.4.post_attention_layernorm.weight": "model-00002-of-00002.safetensors", "model.layers.33.mlp.down_proj.weight": "model-00002-of-00002.safetensors", "model.layers.34.mlp.up_proj.weight": "model-00002-of-00002.safetensors", "model.layers.4.self_attn.k_proj.weight": "model-00002-of-00002.safetensors", "model.layers.9.self_attn.v_proj.weight": "model-00002-of-00002.safetensors", "model.layers.5.self_attn.q_proj.weight": "model-00002-of-00002.safetensors", "model.layers.5.input_layernorm.weight": "model-00002-of-00002.safetensors", "model.layers.5.post_attention_layernorm.weight": "model-00002-of-00002.safetensors", "model.layers.34.mlp.down_proj.weight": "model-00002-of-00002.safetensors", "model.layers.35.mlp.up_proj.weight": "model-00002-of-00002.safetensors", "model.layers.5.self_attn.k_proj.weight": "model-00002-of-00002.safetensors", "model.layers.6.self_attn.q_proj.weight": "model-00002-of-00002.safetensors", "model.layers.6.input_layernorm.weight": "model-00002-of-00002.safetensors", "model.layers.6.post_attention_layernorm.weight": "model-00002-of-00002.safetensors", "model.layers.35.mlp.down_proj.weight": "model-00002-of-00002.safetensors", "model.layers.4.mlp.up_proj.weight": "model-00002-of-00002.safetensors", "model.layers.6.self_attn.k_proj.weight": "model-00002-of-00002.safetensors", "model.layers.7.self_attn.q_proj.weight": "model-00002-of-00002.safetensors", "model.layers.7.input_layernorm.weight": "model-00002-of-00002.safetensors", "model.layers.7.post_attention_layernorm.weight": "model-00002-of-00002.safetensors", "model.layers.4.mlp.down_proj.weight": "model-00002-of-00002.safetensors", "model.layers.5.mlp.up_proj.weight": "model-00002-of-00002.safetensors", "model.layers.7.self_attn.k_proj.weight": "model-00002-of-00002.safetensors", "model.layers.8.self_attn.q_proj.weight": "model-00002-of-00002.safetensors", "model.layers.8.input_layernorm.weight": "model-00002-of-00002.safetensors", "model.layers.8.post_attention_layernorm.weight": "model-00002-of-00002.safetensors", "model.layers.5.mlp.down_proj.weight": "model-00002-of-00002.safetensors", "model.layers.6.mlp.up_proj.weight": "model-00002-of-00002.safetensors", "model.layers.8.self_attn.k_proj.weight": "model-00002-of-00002.safetensors", "model.layers.9.self_attn.q_proj.weight": "model-00002-of-00002.safetensors", "model.layers.9.input_layernorm.weight": "model-00002-of-00002.safetensors", "model.layers.9.post_attention_layernorm.weight": "model-00002-of-00002.safetensors", "model.layers.6.mlp.down_proj.weight": "model-00002-of-00002.safetensors", "model.layers.7.mlp.up_proj.weight": "model-00002-of-00002.safetensors", "model.norm.weight": "model-00002-of-00002.safetensors", "model.layers.9.self_attn.k_proj.weight": "model-00002-of-00002.safetensors", "model.layers.7.mlp.down_proj.weight": "model-00002-of-00002.safetensors", "model.layers.8.mlp.up_proj.weight": "model-00002-of-00002.safetensors", "model.layers.8.mlp.down_proj.weight": "model-00002-of-00002.safetensors", "model.layers.9.mlp.up_proj.weight": "model-00002-of-00002.safetensors", "model.layers.9.mlp.down_proj.weight": "model-00002-of-00002.safetensors", "lm_head.weight": "model-00002-of-00002.safetensors", "model.embed_tokens.weight": "model-00002-of-00002.safetensors", "model.layers.10.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.11.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.12.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.13.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.14.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.15.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.16.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.17.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.18.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.19.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.2.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.20.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.21.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.22.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.23.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.24.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.25.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.26.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.27.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.28.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.29.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.3.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.30.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.31.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.32.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.33.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.34.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.35.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.4.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.5.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.6.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.7.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.8.self_attn.o_proj.weight": "model-00002-of-00002.safetensors", "model.layers.9.self_attn.o_proj.weight": "model-00002-of-00002.safetensors"}}
|
special_tokens_map.json
ADDED
|
@@ -0,0 +1,16 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"bos_token": {
|
| 3 |
+
"content": "<|begin_of_text|>",
|
| 4 |
+
"lstrip": false,
|
| 5 |
+
"normalized": false,
|
| 6 |
+
"rstrip": false,
|
| 7 |
+
"single_word": false
|
| 8 |
+
},
|
| 9 |
+
"eos_token": {
|
| 10 |
+
"content": "<|end_of_text|>",
|
| 11 |
+
"lstrip": false,
|
| 12 |
+
"normalized": false,
|
| 13 |
+
"rstrip": false,
|
| 14 |
+
"single_word": false
|
| 15 |
+
}
|
| 16 |
+
}
|
tokenizer.json
ADDED
|
@@ -0,0 +1,3 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
version https://git-lfs.github.com/spec/v1
|
| 2 |
+
oid sha256:2f7e8b61d1cb49d927a5f5aaeecdac9cb173cccb3ec1897cb5d7bb08bda54907
|
| 3 |
+
size 17157913
|
tokenizer_config.json
ADDED
|
@@ -0,0 +1,46 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
{
|
| 2 |
+
"added_tokens_decoder": {
|
| 3 |
+
"128000": {
|
| 4 |
+
"content": "<|begin_of_text|>",
|
| 5 |
+
"lstrip": false,
|
| 6 |
+
"normalized": false,
|
| 7 |
+
"rstrip": false,
|
| 8 |
+
"single_word": false,
|
| 9 |
+
"special": true
|
| 10 |
+
},
|
| 11 |
+
"128001": {
|
| 12 |
+
"content": "<|end_of_text|>",
|
| 13 |
+
"lstrip": false,
|
| 14 |
+
"normalized": false,
|
| 15 |
+
"rstrip": false,
|
| 16 |
+
"single_word": false,
|
| 17 |
+
"special": true
|
| 18 |
+
},
|
| 19 |
+
"128002": {
|
| 20 |
+
"content": "<|im_start|>",
|
| 21 |
+
"lstrip": false,
|
| 22 |
+
"normalized": false,
|
| 23 |
+
"rstrip": false,
|
| 24 |
+
"single_word": false,
|
| 25 |
+
"special": true
|
| 26 |
+
},
|
| 27 |
+
"128003": {
|
| 28 |
+
"content": "<|im_end|>",
|
| 29 |
+
"lstrip": false,
|
| 30 |
+
"normalized": false,
|
| 31 |
+
"rstrip": false,
|
| 32 |
+
"single_word": false,
|
| 33 |
+
"special": true
|
| 34 |
+
}
|
| 35 |
+
},
|
| 36 |
+
"bos_token": "<|begin_of_text|>",
|
| 37 |
+
"clean_up_tokenization_spaces": true,
|
| 38 |
+
"eos_token": "<|end_of_text|>",
|
| 39 |
+
"extra_special_tokens": {},
|
| 40 |
+
"model_input_names": [
|
| 41 |
+
"input_ids",
|
| 42 |
+
"attention_mask"
|
| 43 |
+
],
|
| 44 |
+
"model_max_length": 65536,
|
| 45 |
+
"tokenizer_class": "PreTrainedTokenizerFast"
|
| 46 |
+
}
|