

Upload VideoX-Fun/README_ja-JP.md
Browse files- VideoX-Fun/README_ja-JP.md +640 -0
VideoX-Fun/README_ja-JP.md
ADDED
|
@@ -0,0 +1,640 @@
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 1 |
+
# VideoX-Fun
|
| 2 |
+
|
| 3 |
+
😊 ようこそ!
|
| 4 |
+
|
| 5 |
+
CogVideoX-Fun:
|
| 6 |
+
[](https://huggingface.co/spaces/alibaba-pai/CogVideoX-Fun-5b)
|
| 7 |
+
|
| 8 |
+
Wan-Fun:
|
| 9 |
+
[](https://huggingface.co/spaces/alibaba-pai/Wan2.1-Fun-1.3B-InP)
|
| 10 |
+
|
| 11 |
+
[English](./README.md) | [简体中文](./README_zh-CN.md) | 日本語
|
| 12 |
+
|
| 13 |
+
# 目次
|
| 14 |
+
- [目次](#目次)
|
| 15 |
+
- [紹介](#紹介)
|
| 16 |
+
- [クイックスタート](#クイックスタート)
|
| 17 |
+
- [ビデオ結果](#ビデオ結果)
|
| 18 |
+
- [使用方法](#使用方法)
|
| 19 |
+
- [モデルの場所](#モデルの場所)
|
| 20 |
+
- [参考文献](#参考文献)
|
| 21 |
+
- [ライセンス](#ライセンス)
|
| 22 |
+
|
| 23 |
+
# 紹介
|
| 24 |
+
VideoX-Funはビデオ生成のパイプラインであり、AI画像やビデオの生成、Diffusion TransformerのベースラインモデルとLoraモデルのトレーニングに使用できます。我々は、すでに学習済みのベースラインモデルから直接予測を行い、異なる解像度、秒数、FPSのビデオを生成することをサポートしています。また、ユーザーが独自のベースラインモデルやLoraモデルをトレーニングし、特定のスタイル変換を行うこともサポートしています。
|
| 25 |
+
|
| 26 |
+
異なるプラットフォームからのクイックスタートをサポートします。詳細は[クイックスタート](#クイックスタート)を参照してください。
|
| 27 |
+
|
| 28 |
+
新機能:
|
| 29 |
+
- Wan2.1-Fun-V1.1バージョンを更新:14Bと1.3BモデルのControl+参照画像モデルをサポート、カメラ制御にも対応。さらに、Inpaintモデルを再訓練し、性能が向上しました。[2025.04.25]
|
| 30 |
+
- Wan2.1-Fun-V1.0の更新:14Bおよび1.3BのI2V(画像からビデオ)モデルとControlモデルをサポートし、開始フレームと終了フレームの予測に対応。[2025.03.26]
|
| 31 |
+
- CogVideoX-Fun-V1.5の更新:I2Vモデルと関連するトレーニング・予測コードをアップロード。[2024.12.16]
|
| 32 |
+
- 報酬Loraのサポート:報酬逆伝播技術を使用してLoraをトレーニングし、生成された動画を最適化し、人間の好みによりよく一致させる。[詳細情報](scripts/README_TRAIN_REWARD.md)。新しいバージョンの制御モデルでは、Canny、Depth、Pose、MLSDなどの異なる制御条件に対応。[2024.11.21]
|
| 33 |
+
- diffusersのサポート:CogVideoX-Fun Controlがdiffusersでサポートされるようになりました。[a-r-r-o-w](https://github.com/a-r-r-o-w)がこの[PR](https://github.com/huggingface/diffusers/pull/9671)でサポートを提供してくれたことに感謝します。詳細は[ドキュメント](https://huggingface.co/docs/diffusers/main/en/api/pipelines/cogvideox)をご覧ください。[2024.10.16]
|
| 34 |
+
- CogVideoX-Fun-V1.1の更新:i2vモデルを再トレーニングし、Noiseを追加して動画の動きの範囲を拡大。制御モデルのトレーニングコードとControlモデルをアップロード。[2024.09.29]
|
| 35 |
+
- CogVideoX-Fun-V1.0の更新:コードを作成!WindowsとLinuxに対応しました。2Bおよび5Bモデルでの最大256x256x49から1024x1024x49までの任意の解像度の動画生成をサポート。[2024.09.18]
|
| 36 |
+
|
| 37 |
+
機能:
|
| 38 |
+
- [データ前処理](#data-preprocess)
|
| 39 |
+
- [DiTのトレーニング](#dit-train)
|
| 40 |
+
- [ビデオ生成](#video-gen)
|
| 41 |
+
|
| 42 |
+
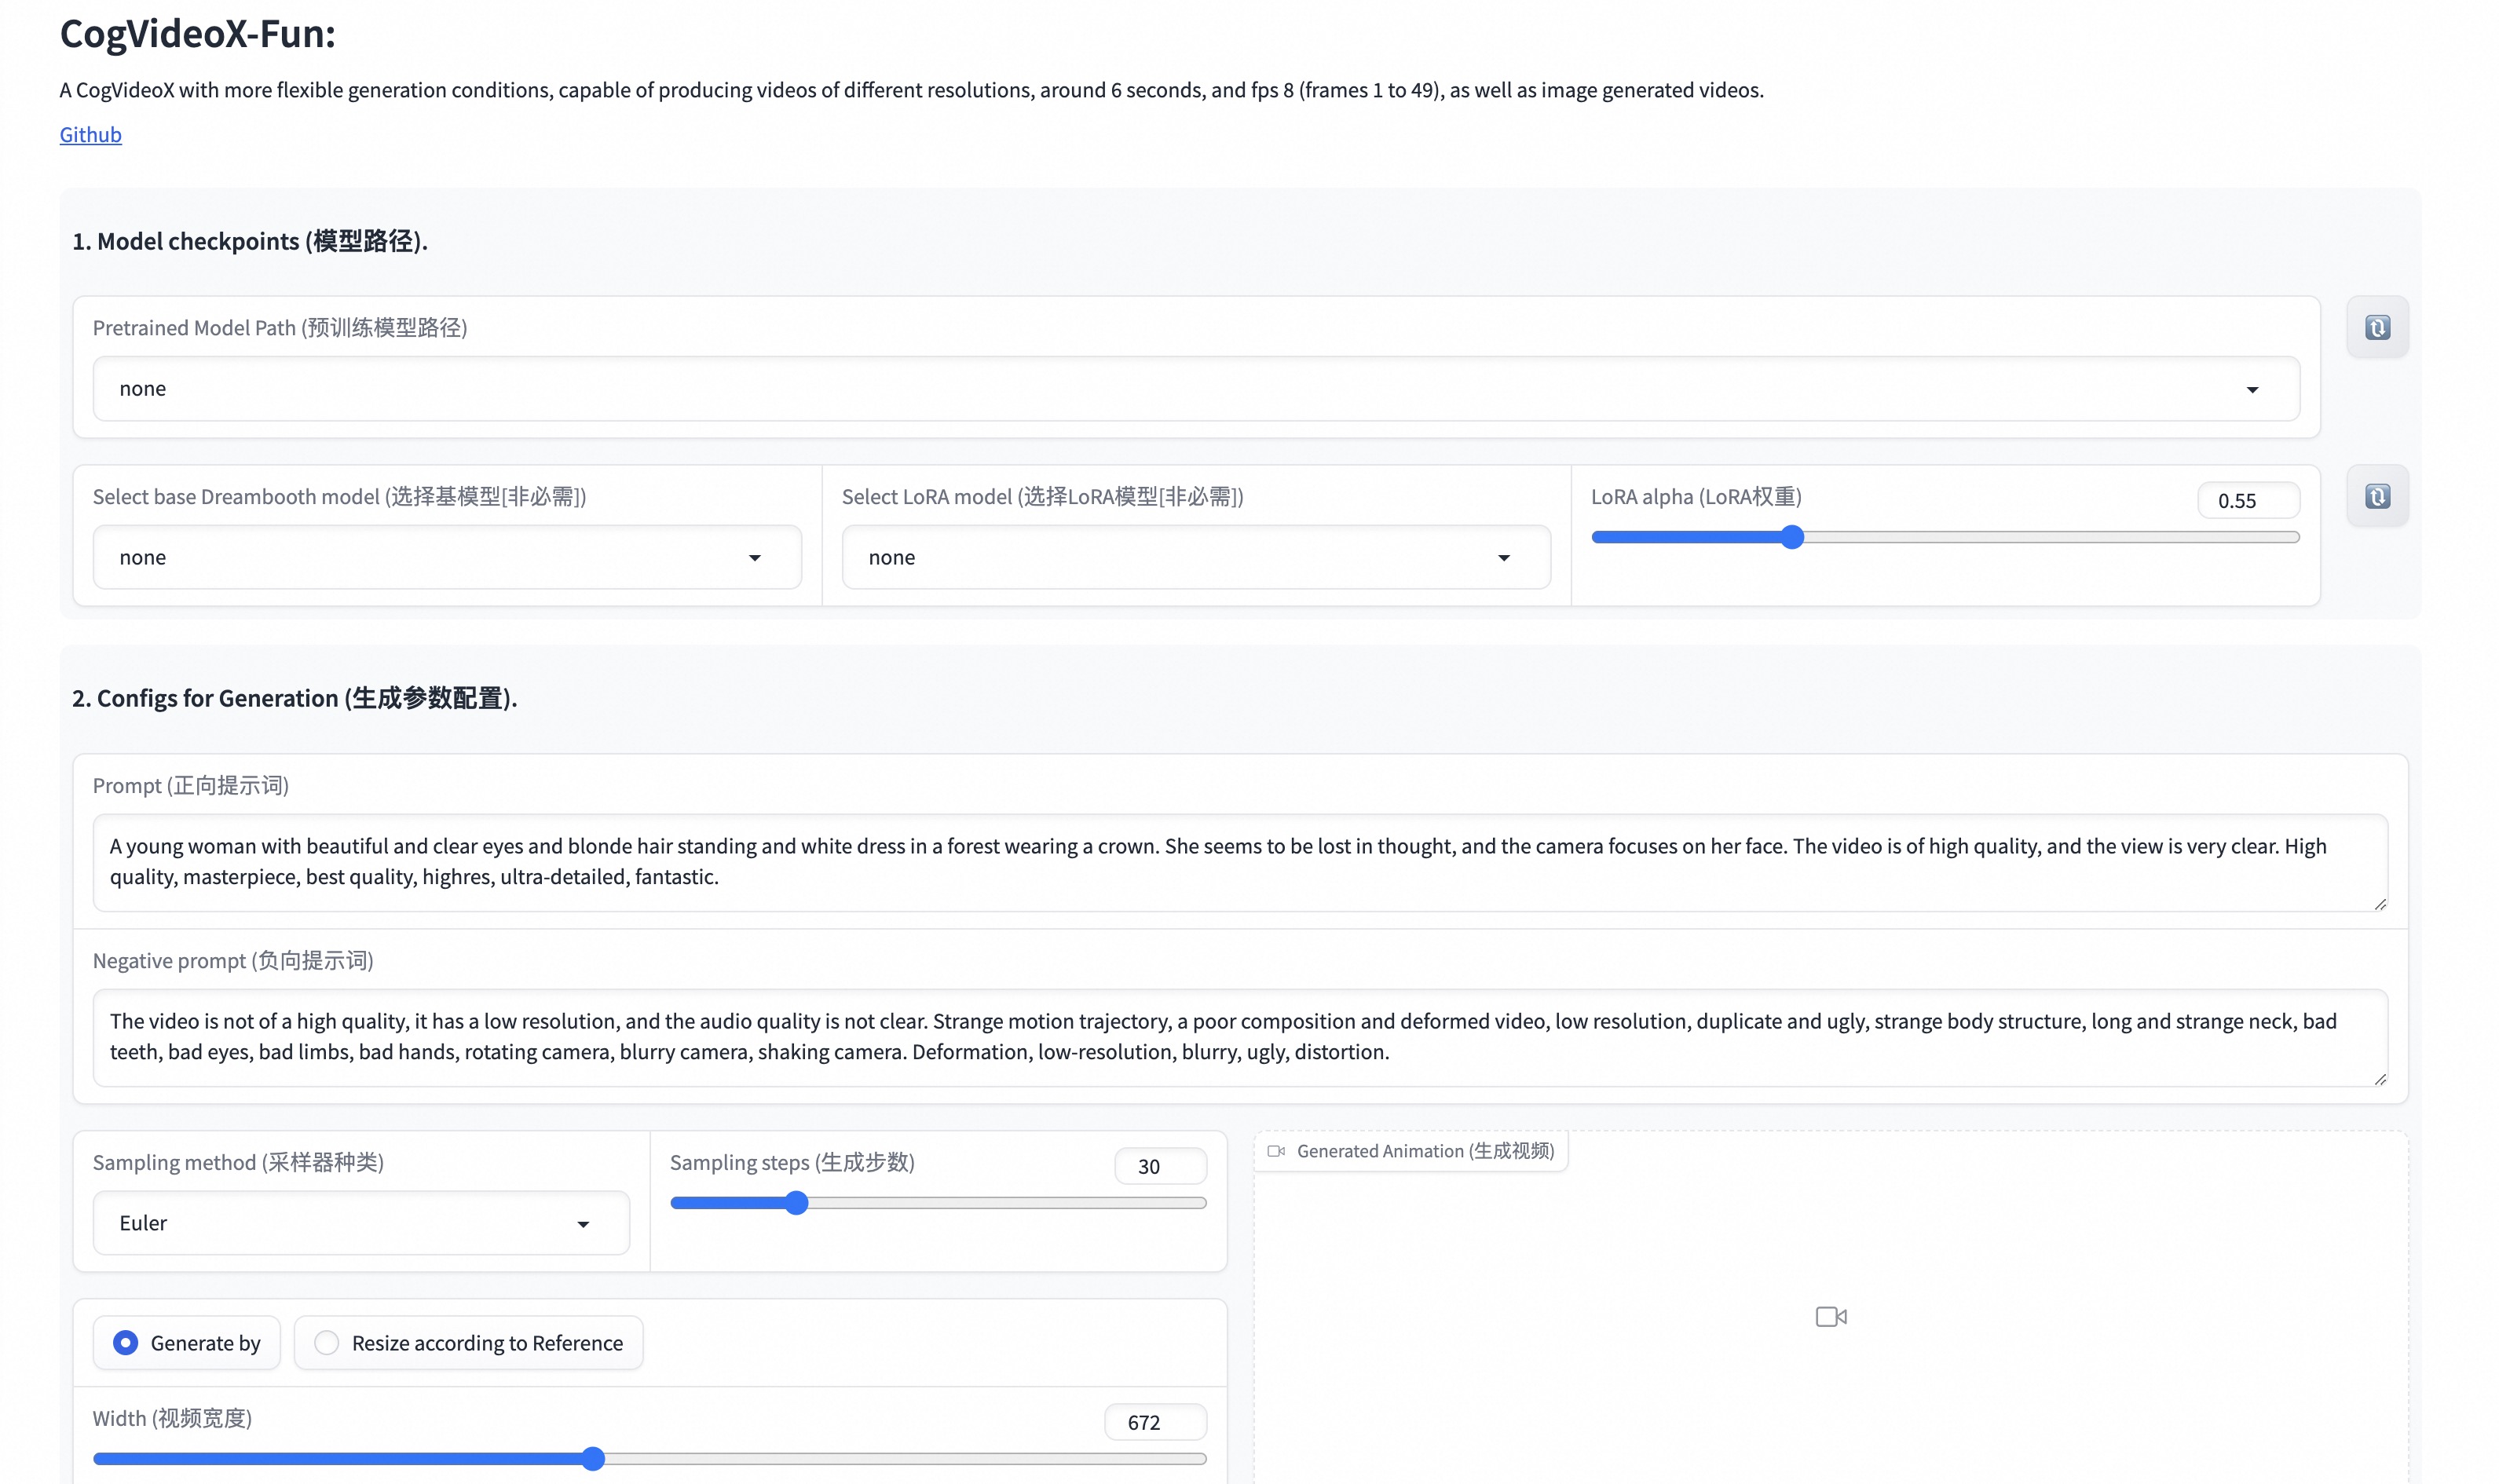
私たちのUIインターフェースは次のとおりです:
|
| 43 |
+
|
| 44 |
+
|
| 45 |
+
# クイックスタート
|
| 46 |
+
### 1. クラウド使用: AliyunDSW/Docker
|
| 47 |
+
#### a. AliyunDSWから
|
| 48 |
+
DSWには無料のGPU時間があり、ユーザーは一度申請でき、申請後3か月間有効です。
|
| 49 |
+
|
| 50 |
+
Aliyunは[Freetier](https://free.aliyun.com/?product=9602825&crowd=enterprise&spm=5176.28055625.J_5831864660.1.e939154aRgha4e&scm=20140722.M_9974135.P_110.MO_1806-ID_9974135-MID_9974135-CID_30683-ST_8512-V_1)で無料のGPU時間を提供しています。取得してAliyun PAI-DSWで使用し、5分以内にCogVideoX-Funを開始できます!
|
| 51 |
+
|
| 52 |
+
[](https://gallery.pai-ml.com/#/preview/deepLearning/cv/cogvideox_fun)
|
| 53 |
+
|
| 54 |
+
#### b. ComfyUIから
|
| 55 |
+
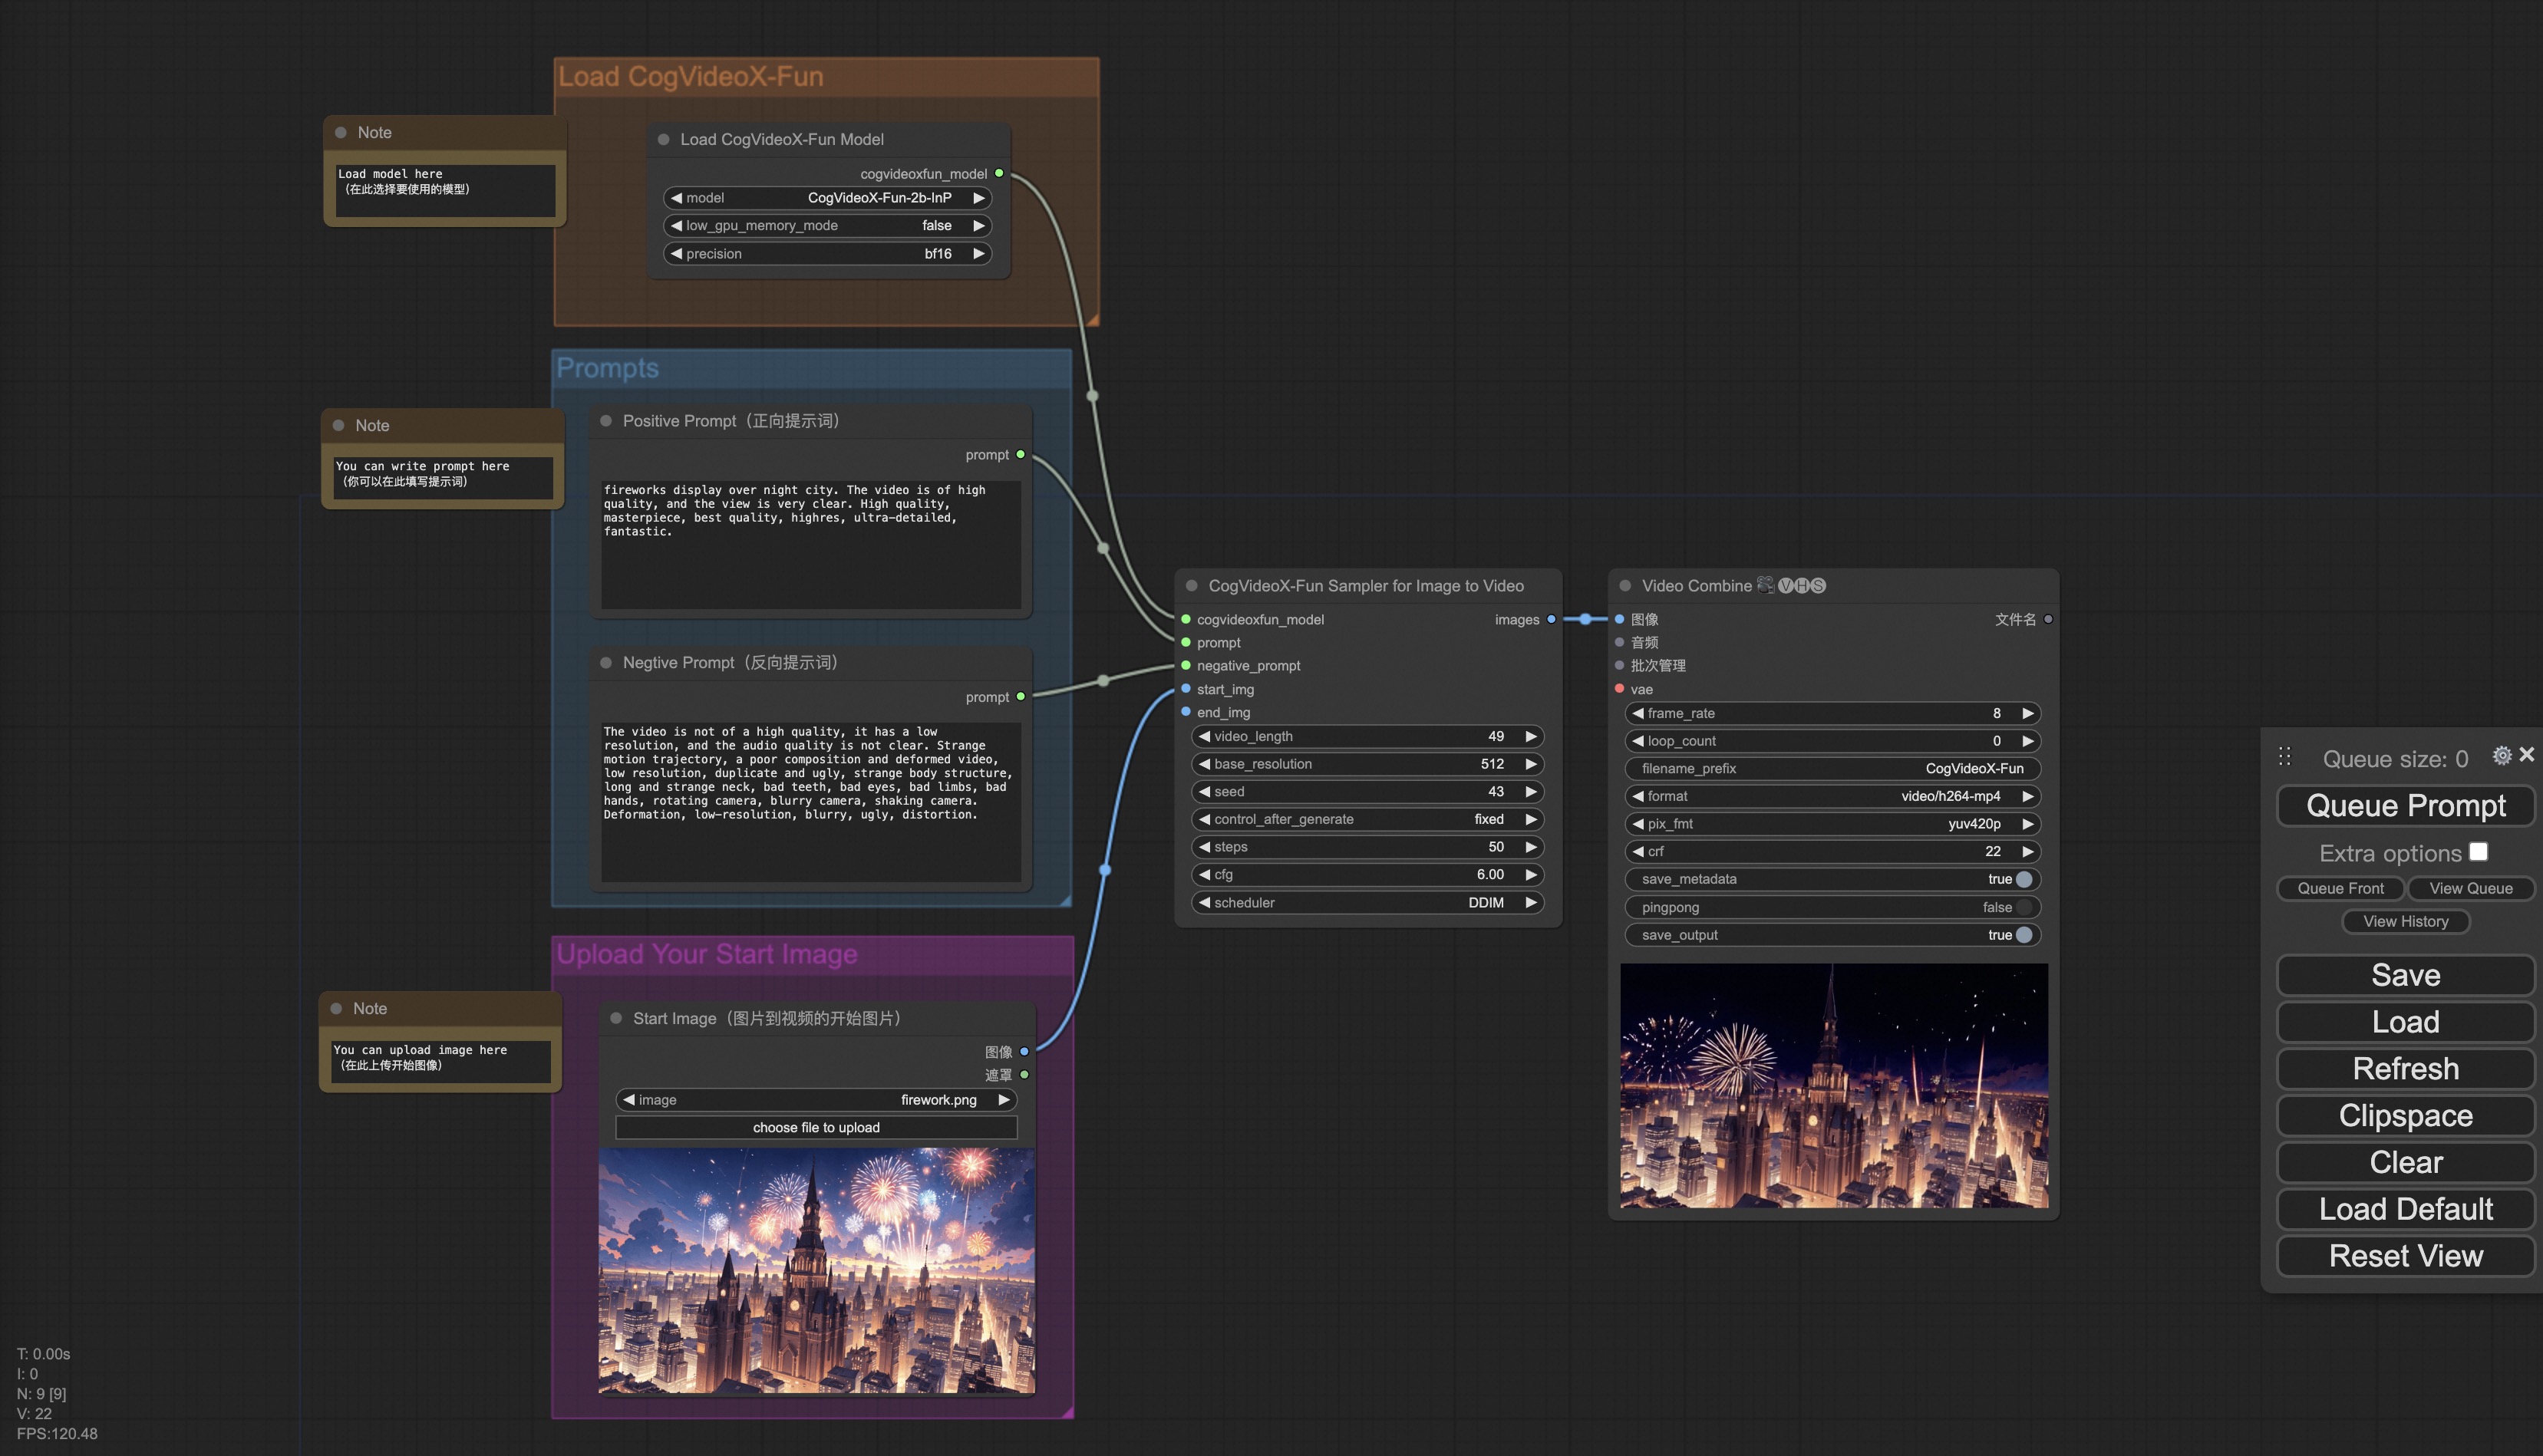
私たちのComfyUIは次のとおりです。詳細は[ComfyUI README](comfyui/README.md)を参照してください。
|
| 56 |
+
|
| 57 |
+
|
| 58 |
+
#### c. Dockerから
|
| 59 |
+
Dockerを使用する場合、マシンにグラフィックスカードドライバとCUDA環境が正しくインストールされていることを確認してください。
|
| 60 |
+
|
| 61 |
+
次のコマンドをこの方法で実行します:
|
| 62 |
+
|
| 63 |
+
```
|
| 64 |
+
# イメージをプル
|
| 65 |
+
docker pull mybigpai-public-registry.cn-beijing.cr.aliyuncs.com/easycv/torch_cuda:cogvideox_fun
|
| 66 |
+
|
| 67 |
+
# イメージに入る
|
| 68 |
+
docker run -it -p 7860:7860 --network host --gpus all --security-opt seccomp:unconfined --shm-size 200g mybigpai-public-registry.cn-beijing.cr.aliyuncs.com/easycv/torch_cuda:cogvideox_fun
|
| 69 |
+
|
| 70 |
+
# コードをクローン
|
| 71 |
+
git clone https://github.com/aigc-apps/VideoX-Fun.git
|
| 72 |
+
|
| 73 |
+
# VideoX-Funのディレクトリに入る
|
| 74 |
+
cd VideoX-Fun
|
| 75 |
+
|
| 76 |
+
# 重みをダウンロード
|
| 77 |
+
mkdir models/Diffusion_Transformer
|
| 78 |
+
mkdir models/Personalized_Model
|
| 79 |
+
|
| 80 |
+
# Please use the hugginface link or modelscope link to download the model.
|
| 81 |
+
# CogVideoX-Fun
|
| 82 |
+
# https://huggingface.co/alibaba-pai/CogVideoX-Fun-V1.1-5b-InP
|
| 83 |
+
# https://modelscope.cn/models/PAI/CogVideoX-Fun-V1.1-5b-InP
|
| 84 |
+
|
| 85 |
+
# Wan
|
| 86 |
+
# https://huggingface.co/alibaba-pai/Wan2.1-Fun-V1.1-14B-InP
|
| 87 |
+
# https://modelscope.cn/models/PAI/Wan2.1-Fun-V1.1-14B-InP
|
| 88 |
+
```
|
| 89 |
+
|
| 90 |
+
### 2. ローカルインストール: 環境チェック/ダウンロード/インストール
|
| 91 |
+
#### a. 環境チェック
|
| 92 |
+
以下の環境でこのライブラリの実行を確認しています:
|
| 93 |
+
|
| 94 |
+
Windowsの詳細:
|
| 95 |
+
- OS: Windows 10
|
| 96 |
+
- python: python3.10 & python3.11
|
| 97 |
+
- pytorch: torch2.2.0
|
| 98 |
+
- CUDA: 11.8 & 12.1
|
| 99 |
+
- CUDNN: 8+
|
| 100 |
+
- GPU: Nvidia-3060 12G & Nvidia-3090 24G
|
| 101 |
+
|
| 102 |
+
Linuxの詳細:
|
| 103 |
+
- OS: Ubuntu 20.04, CentOS
|
| 104 |
+
- python: python3.10 & python3.11
|
| 105 |
+
- pytorch: torch2.2.0
|
| 106 |
+
- CUDA: 11.8 & 12.1
|
| 107 |
+
- CUDNN: 8+
|
| 108 |
+
- GPU:Nvidia-V100 16G & Nvidia-A10 24G & Nvidia-A100 40G & Nvidia-A100 80G
|
| 109 |
+
|
| 110 |
+
重みを保存するために約60GBのディスクスペースが必要です。確認してください!
|
| 111 |
+
|
| 112 |
+
#### b. 重み
|
| 113 |
+
[重み](#model-zoo)を指定されたパスに配置することをお勧めします:
|
| 114 |
+
|
| 115 |
+
**ComfyUIを通じて**:
|
| 116 |
+
モデルをComfyUIの重みフォルダ `ComfyUI/models/Fun_Models/` に入れます:
|
| 117 |
+
```
|
| 118 |
+
📦 ComfyUI/
|
| 119 |
+
├── 📂 models/
|
| 120 |
+
│ └── 📂 Fun_Models/
|
| 121 |
+
│ ├── 📂 CogVideoX-Fun-V1.1-2b-InP/
|
| 122 |
+
│ ├── 📂 CogVideoX-Fun-V1.1-5b-InP/
|
| 123 |
+
│ ├── 📂 Wan2.1-Fun-V1.1-14B-InP
|
| 124 |
+
│ └── 📂 Wan2.1-Fun-V1.1-1.3B-InP/
|
| 125 |
+
```
|
| 126 |
+
|
| 127 |
+
**独自のpythonファイルまたはUIインターフェースを実行**:
|
| 128 |
+
```
|
| 129 |
+
📦 models/
|
| 130 |
+
├── 📂 Diffusion_Transformer/
|
| 131 |
+
│ ├── 📂 CogVideoX-Fun-V1.1-2b-InP/
|
| 132 |
+
│ ├── 📂 CogVideoX-Fun-V1.1-5b-InP/
|
| 133 |
+
│ ├── 📂 Wan2.1-Fun-V1.1-14B-InP
|
| 134 |
+
│ └── 📂 Wan2.1-Fun-V1.1-1.3B-InP/
|
| 135 |
+
├── 📂 Personalized_Model/
|
| 136 |
+
│ └── あなたのトレーニング済みのトランスフォーマーモデル / あなたのトレーニング済みのLoraモデル(UIロード用)
|
| 137 |
+
```
|
| 138 |
+
|
| 139 |
+
# ビデオ結果
|
| 140 |
+
|
| 141 |
+
### Wan2.1-Fun-V1.1-14B-InP && Wan2.1-Fun-V1.1-1.3B-InP
|
| 142 |
+
|
| 143 |
+
<table border="0" style="width: 100%; text-align: left; margin-top: 20px;">
|
| 144 |
+
<tr>
|
| 145 |
+
<td>
|
| 146 |
+
<video src="https://github.com/user-attachments/assets/d6a46051-8fe6-4174-be12-95ee52c96298" width="100%" controls autoplay loop></video>
|
| 147 |
+
</td>
|
| 148 |
+
<td>
|
| 149 |
+
<video src="https://github.com/user-attachments/assets/8572c656-8548-4b1f-9ec8-8107c6236cb1" width="100%" controls autoplay loop></video>
|
| 150 |
+
</td>
|
| 151 |
+
<td>
|
| 152 |
+
<video src="https://github.com/user-attachments/assets/d3411c95-483d-4e30-bc72-483c2b288918" width="100%" controls autoplay loop></video>
|
| 153 |
+
</td>
|
| 154 |
+
<td>
|
| 155 |
+
<video src="https://github.com/user-attachments/assets/b2f5addc-06bd-49d9-b925-973090a32800" width="100%" controls autoplay loop></video>
|
| 156 |
+
</td>
|
| 157 |
+
</tr>
|
| 158 |
+
</table>
|
| 159 |
+
|
| 160 |
+
<table border="0" style="width: 100%; text-align: left; margin-top: 20px;">
|
| 161 |
+
<tr>
|
| 162 |
+
<td>
|
| 163 |
+
<video src="https://github.com/user-attachments/assets/747b6ab8-9617-4ba2-84a0-b51c0efbd4f8" width="100%" controls autoplay loop></video>
|
| 164 |
+
</td>
|
| 165 |
+
<td>
|
| 166 |
+
<video src="https://github.com/user-attachments/assets/ae94dcda-9d5e-4bae-a86f-882c4282a367" width="100%" controls autoplay loop></video>
|
| 167 |
+
</td>
|
| 168 |
+
<td>
|
| 169 |
+
<video src="https://github.com/user-attachments/assets/a4aa1a82-e162-4ab5-8f05-72f79568a191" width="100%" controls autoplay loop></video>
|
| 170 |
+
</td>
|
| 171 |
+
<td>
|
| 172 |
+
<video src="https://github.com/user-attachments/assets/83c005b8-ccbc-44a0-a845-c0472763119c" width="100%" controls autoplay loop></video>
|
| 173 |
+
</td>
|
| 174 |
+
</tr>
|
| 175 |
+
</table>
|
| 176 |
+
|
| 177 |
+
### Wan2.1-Fun-V1.1-14B-Control && Wan2.1-Fun-V1.1-1.3B-Control
|
| 178 |
+
|
| 179 |
+
Generic Control Video + Reference Image:
|
| 180 |
+
<table border="0" style="width: 100%; text-align: left; margin-top: 20px;">
|
| 181 |
+
<tr>
|
| 182 |
+
<td>
|
| 183 |
+
Reference Image
|
| 184 |
+
</td>
|
| 185 |
+
<td>
|
| 186 |
+
Control Video
|
| 187 |
+
</td>
|
| 188 |
+
<td>
|
| 189 |
+
Wan2.1-Fun-V1.1-14B-Control
|
| 190 |
+
</td>
|
| 191 |
+
<td>
|
| 192 |
+
Wan2.1-Fun-V1.1-1.3B-Control
|
| 193 |
+
</td>
|
| 194 |
+
<tr>
|
| 195 |
+
<td>
|
| 196 |
+
<image src="https://github.com/user-attachments/assets/221f2879-3b1b-4fbd-84f9-c3e0b0b3533e" width="100%" controls autoplay loop></image>
|
| 197 |
+
</td>
|
| 198 |
+
<td>
|
| 199 |
+
<video src="https://github.com/user-attachments/assets/f361af34-b3b3-4be4-9d03-cd478cb3dfc5" width="100%" controls autoplay loop></video>
|
| 200 |
+
</td>
|
| 201 |
+
<td>
|
| 202 |
+
<video src="https://github.com/user-attachments/assets/85e2f00b-6ef0-4922-90ab-4364afb2c93d" width="100%" controls autoplay loop></video>
|
| 203 |
+
</td>
|
| 204 |
+
<td>
|
| 205 |
+
<video src="https://github.com/user-attachments/assets/1f3fe763-2754-4215-bc9a-ae804950d4b3" width="100%" controls autoplay loop></video>
|
| 206 |
+
</td>
|
| 207 |
+
<tr>
|
| 208 |
+
</table>
|
| 209 |
+
|
| 210 |
+
|
| 211 |
+
Generic Control Video (Canny, Pose, Depth, etc.) and Trajectory Control:
|
| 212 |
+
<table border="0" style="width: 100%; text-align: left; margin-top: 20px;">
|
| 213 |
+
<tr>
|
| 214 |
+
<td>
|
| 215 |
+
<video src="https://github.com/user-attachments/assets/f35602c4-9f0a-4105-9762-1e3a88abbac6" width="100%" controls autoplay loop></video>
|
| 216 |
+
</td>
|
| 217 |
+
<td>
|
| 218 |
+
<video src="https://github.com/user-attachments/assets/8b0f0e87-f1be-4915-bb35-2d53c852333e" width="100%" controls autoplay loop></video>
|
| 219 |
+
</td>
|
| 220 |
+
<td>
|
| 221 |
+
<video src="https://github.com/user-attachments/assets/972012c1-772b-427a-bce6-ba8b39edcfad" width="100%" controls autoplay loop></video>
|
| 222 |
+
</td>
|
| 223 |
+
<tr>
|
| 224 |
+
</table>
|
| 225 |
+
|
| 226 |
+
<table border="0" style="width: 100%; text-align: left; margin-top: 20px;">
|
| 227 |
+
<tr>
|
| 228 |
+
<td>
|
| 229 |
+
<video src="https://github.com/user-attachments/assets/ce62d0bd-82c0-4d7b-9c49-7e0e4b605745" width="100%" controls autoplay loop></video>
|
| 230 |
+
</td>
|
| 231 |
+
<td>
|
| 232 |
+
<video src="https://github.com/user-attachments/assets/89dfbffb-c4a6-4821-bcef-8b1489a3ca00" width="100%" controls autoplay loop></video>
|
| 233 |
+
</td>
|
| 234 |
+
<td>
|
| 235 |
+
<video src="https://github.com/user-attachments/assets/72a43e33-854f-4349-861b-c959510d1a84" width="100%" controls autoplay loop></video>
|
| 236 |
+
</td>
|
| 237 |
+
<tr>
|
| 238 |
+
<td>
|
| 239 |
+
<video src="https://github.com/user-attachments/assets/bb0ce13d-dee0-4049-9eec-c92f3ebc1358" width="100%" controls autoplay loop></video>
|
| 240 |
+
</td>
|
| 241 |
+
<td>
|
| 242 |
+
<video src="https://github.com/user-attachments/assets/7840c333-7bec-4582-ba63-20a39e1139c4" width="100%" controls autoplay loop></video>
|
| 243 |
+
</td>
|
| 244 |
+
<td>
|
| 245 |
+
<video src="https://github.com/user-attachments/assets/85147d30-ae09-4f36-a077-2167f7a578c0" width="100%" controls autoplay loop></video>
|
| 246 |
+
</td>
|
| 247 |
+
</tr>
|
| 248 |
+
</table>
|
| 249 |
+
|
| 250 |
+
### Wan2.1-Fun-V1.1-14B-Control-Camera && Wan2.1-Fun-V1.1-1.3B-Control-Camera
|
| 251 |
+
|
| 252 |
+
<table border="0" style="width: 100%; text-align: left; margin-top: 20px;">
|
| 253 |
+
<tr>
|
| 254 |
+
<td>
|
| 255 |
+
Pan Up
|
| 256 |
+
</td>
|
| 257 |
+
<td>
|
| 258 |
+
Pan Left
|
| 259 |
+
</td>
|
| 260 |
+
<td>
|
| 261 |
+
Pan Right
|
| 262 |
+
</td>
|
| 263 |
+
<tr>
|
| 264 |
+
<td>
|
| 265 |
+
<video src="https://github.com/user-attachments/assets/869fe2ef-502a-484e-8656-fe9e626b9f63" width="100%" controls autoplay loop></video>
|
| 266 |
+
</td>
|
| 267 |
+
<td>
|
| 268 |
+
<video src="https://github.com/user-attachments/assets/2d4185c8-d6ec-4831-83b4-b1dbfc3616fa" width="100%" controls autoplay loop></video>
|
| 269 |
+
</td>
|
| 270 |
+
<td>
|
| 271 |
+
<video src="https://github.com/user-attachments/assets/7dfb7cad-ed24-4acc-9377-832445a07ec7" width="100%" controls autoplay loop></video>
|
| 272 |
+
</td>
|
| 273 |
+
<tr>
|
| 274 |
+
<td>
|
| 275 |
+
Pan Down
|
| 276 |
+
</td>
|
| 277 |
+
<td>
|
| 278 |
+
Pan Up + Pan Left
|
| 279 |
+
</td>
|
| 280 |
+
<td>
|
| 281 |
+
Pan Up + Pan Right
|
| 282 |
+
</td>
|
| 283 |
+
<tr>
|
| 284 |
+
<td>
|
| 285 |
+
<video src="https://github.com/user-attachments/assets/3ea3a08d-f2df-43a2-976e-bf2659345373" width="100%" controls autoplay loop></video>
|
| 286 |
+
</td>
|
| 287 |
+
<td>
|
| 288 |
+
<video src="https://github.com/user-attachments/assets/4a85b028-4120-4293-886b-b8afe2d01713" width="100%" controls autoplay loop></video>
|
| 289 |
+
</td>
|
| 290 |
+
<td>
|
| 291 |
+
<video src="https://github.com/user-attachments/assets/ad0d58c1-13ef-450c-b658-4fed7ff5ed36" width="100%" controls autoplay loop></video>
|
| 292 |
+
</td>
|
| 293 |
+
</tr>
|
| 294 |
+
</table>
|
| 295 |
+
|
| 296 |
+
### CogVideoX-Fun-V1.1-5B
|
| 297 |
+
|
| 298 |
+
解像度-1024
|
| 299 |
+
|
| 300 |
+
<table border="0" style="width: 100%; text-align: left; margin-top: 20px;">
|
| 301 |
+
<tr>
|
| 302 |
+
<td>
|
| 303 |
+
<video src="https://github.com/user-attachments/assets/34e7ec8f-293e-4655-bb14-5e1ee476f788" width="100%" controls autoplay loop></video>
|
| 304 |
+
</td>
|
| 305 |
+
<td>
|
| 306 |
+
<video src="https://github.com/user-attachments/assets/7809c64f-eb8c-48a9-8bdc-ca9261fd5434" width="100%" controls autoplay loop></video>
|
| 307 |
+
</td>
|
| 308 |
+
<td>
|
| 309 |
+
<video src="https://github.com/user-attachments/assets/8e76aaa4-c602-44ac-bcb4-8b24b72c386c" width="100%" controls autoplay loop></video>
|
| 310 |
+
</td>
|
| 311 |
+
<td>
|
| 312 |
+
<video src="https://github.com/user-attachments/assets/19dba894-7c35-4f25-b15c-384167ab3b03" width="100%" controls autoplay loop></video>
|
| 313 |
+
</td>
|
| 314 |
+
</tr>
|
| 315 |
+
</table>
|
| 316 |
+
|
| 317 |
+
|
| 318 |
+
解像度-768
|
| 319 |
+
|
| 320 |
+
<table border="0" style="width: 100%; text-align: left; margin-top: 20px;">
|
| 321 |
+
<tr>
|
| 322 |
+
<td>
|
| 323 |
+
<video src="https://github.com/user-attachments/assets/0bc339b9-455b-44fd-8917-80272d702737" width="100%" controls autoplay loop></video>
|
| 324 |
+
</td>
|
| 325 |
+
<td>
|
| 326 |
+
<video src="https://github.com/user-attachments/assets/70a043b9-6721-4bd9-be47-78b7ec5c27e9" width="100%" controls autoplay loop></video>
|
| 327 |
+
</td>
|
| 328 |
+
<td>
|
| 329 |
+
<video src="https://github.com/user-attachments/assets/d5dd6c09-14f3-40f8-8b6d-91e26519b8ac" width="100%" controls autoplay loop></video>
|
| 330 |
+
</td>
|
| 331 |
+
<td>
|
| 332 |
+
<video src="https://github.com/user-attachments/assets/9327e8bc-4f17-46b0-b50d-38c250a9483a" width="100%" controls autoplay loop></video>
|
| 333 |
+
</td>
|
| 334 |
+
</tr>
|
| 335 |
+
</table>
|
| 336 |
+
|
| 337 |
+
解像度-512
|
| 338 |
+
|
| 339 |
+
<table border="0" style="width: 100%; text-align: left; margin-top: 20px;">
|
| 340 |
+
<tr>
|
| 341 |
+
<td>
|
| 342 |
+
<video src="https://github.com/user-attachments/assets/ef407030-8062-454d-aba3-131c21e6b58c" width="100%" controls autoplay loop></video>
|
| 343 |
+
</td>
|
| 344 |
+
<td>
|
| 345 |
+
<video src="https://github.com/user-attachments/assets/7610f49e-38b6-4214-aa48-723ae4d1b07e" width="100%" controls autoplay loop></video>
|
| 346 |
+
</td>
|
| 347 |
+
<td>
|
| 348 |
+
<video src="https://github.com/user-attachments/assets/1fff0567-1e15-415c-941e-53ee8ae2c841" width="100%" controls autoplay loop></video>
|
| 349 |
+
</td>
|
| 350 |
+
<td>
|
| 351 |
+
<video src="https://github.com/user-attachments/assets/bcec48da-b91b-43a0-9d50-cf026e00fa4f" width="100%" controls autoplay loop></video>
|
| 352 |
+
</td>
|
| 353 |
+
</tr>
|
| 354 |
+
</table>
|
| 355 |
+
|
| 356 |
+
### CogVideoX-Fun-V1.1-5B-Control
|
| 357 |
+
|
| 358 |
+
<table border="0" style="width: 100%; text-align: left; margin-top: 20px;">
|
| 359 |
+
<tr>
|
| 360 |
+
<td>
|
| 361 |
+
<video src="https://github.com/user-attachments/assets/53002ce2-dd18-4d4f-8135-b6f68364cabd" width="100%" controls autoplay loop></video>
|
| 362 |
+
</td>
|
| 363 |
+
<td>
|
| 364 |
+
<video src="https://github.com/user-attachments/assets/a1a07cf8-d86d-4cd2-831f-18a6c1ceee1d" width="100%" controls autoplay loop></video>
|
| 365 |
+
</td>
|
| 366 |
+
<td>
|
| 367 |
+
<video src="https://github.com/user-attachments/assets/3224804f-342d-4947-918d-d9fec8e3d273" width="100%" controls autoplay loop></video>
|
| 368 |
+
</td>
|
| 369 |
+
<tr>
|
| 370 |
+
<td>
|
| 371 |
+
美しい澄んだ目と金髪の若い女性が白い服を着て体をひねり、カメラは彼女の顔に焦点を合わせています。高品質、傑作、最高品質、高解像度、超微細、夢のような。
|
| 372 |
+
</td>
|
| 373 |
+
<td>
|
| 374 |
+
美しい澄んだ目と金髪の若い女性が白い服を着て体をひねり、カメラは彼女の顔に焦点を合わせています。高品質、傑作、最高品質、高解像度、超微細、夢のような。
|
| 375 |
+
</td>
|
| 376 |
+
<td>
|
| 377 |
+
若いクマ。
|
| 378 |
+
</td>
|
| 379 |
+
</tr>
|
| 380 |
+
<tr>
|
| 381 |
+
<td>
|
| 382 |
+
<video src="https://github.com/user-attachments/assets/ea908454-684b-4d60-b562-3db229a250a9" width="100%" controls autoplay loop></video>
|
| 383 |
+
</td>
|
| 384 |
+
<td>
|
| 385 |
+
<video src="https://github.com/user-attachments/assets/ffb7c6fc-8b69-453b-8aad-70dfae3899b9" width="100%" controls autoplay loop></video>
|
| 386 |
+
</td>
|
| 387 |
+
<td>
|
| 388 |
+
<video src="https://github.com/user-attachments/assets/d3f757a3-3551-4dcb-9372-7a61469813f5" width="100%" controls autoplay loop></video>
|
| 389 |
+
</td>
|
| 390 |
+
</tr>
|
| 391 |
+
</table>
|
| 392 |
+
|
| 393 |
+
# 使い方
|
| 394 |
+
|
| 395 |
+
<h3 id="video-gen">1. 生成</h3>
|
| 396 |
+
|
| 397 |
+
#### a. GPUメモリ節約方法
|
| 398 |
+
Wan2.1のパラメータが非常に大きいため、GPUメモリを節約し、コンシューマー向けGPUに適応させる必要があります。各予測ファイルには`GPU_memory_mode`を提供しており、`model_cpu_offload`、`model_cpu_offload_and_qfloat8`、`sequential_cpu_offload`の中から選択できます。この方法はCogVideoX-Funの生成にも適用されます。
|
| 399 |
+
|
| 400 |
+
- `model_cpu_offload`: モデル全体が使用後にCPUに移動し、一部のGPUメモリを節約します。
|
| 401 |
+
- `model_cpu_offload_and_qfloat8`: モデル全体が使用後にCPUに移動し、Transformerモデルに対してfloat8の量子化を行い、より多くのGPUメモリを節約します。
|
| 402 |
+
- `sequential_cpu_offload`: モデルの各層が使用後にCPUに移動します。速度は遅くなりますが、大量のGPUメモリを節約します。
|
| 403 |
+
|
| 404 |
+
`qfloat8`はモデルの性能を部分的に低下させる可能性がありますが、より多くのGPUメモリを節約できます。十分なGPUメモリがある場合は、`model_cpu_offload`の使用をお勧めします。
|
| 405 |
+
|
| 406 |
+
#### b. ComfyUIを使用する
|
| 407 |
+
詳細は[ComfyUI README](comfyui/README.md)をご覧ください。
|
| 408 |
+
|
| 409 |
+
#### c. Pythonファイルを実行する
|
| 410 |
+
|
| 411 |
+
##### i. 単一GPUでの推論:
|
| 412 |
+
|
| 413 |
+
- ステップ1: 対応する[重み](#model-zoo)をダウンロードし、`models`フォルダに配置します。
|
| 414 |
+
- ステップ2: 異なる重みと予測目標に基づいて、異なるファイルを使用して予測を行います。現在、このライブラリはCogVideoX-Fun、Wan2.1、およびWan2.1-Funをサポートしています。`examples`フォルダ内のフォルダ名で区別され、異なるモデルがサポートする機能が異なりますので、状況に応じて区別してください。以下はCogVideoX-Funを例として説明します。
|
| 415 |
+
- テキストからビデオ:
|
| 416 |
+
- `examples/cogvideox_fun/predict_t2v.py`ファイルで`prompt`、`neg_prompt`、`guidance_scale`、`seed`を変更します。
|
| 417 |
+
- 次に、`examples/cogvideox_fun/predict_t2v.py`ファイルを実行し、結果が生成されるのを待ちます。結果は`samples/cogvideox-fun-videos`フォルダに保存されます。
|
| 418 |
+
- 画像からビデオ:
|
| 419 |
+
- `examples/cogvideox_fun/predict_i2v.py`ファイルで`validation_image_start`、`validation_image_end`、`prompt`、`neg_prompt`、`guidance_scale`、`seed`を変更します。
|
| 420 |
+
- `validation_image_start`はビデオの開始画像、`validation_image_end`はビデオの終了画像です。
|
| 421 |
+
- 次に、`examples/cogvideox_fun/predict_i2v.py`ファイルを実行し、結果が生成されるのを待ちます。結果は`samples/cogvideox-fun-videos_i2v`フォルダに保存されます。
|
| 422 |
+
- ビデオからビデオ:
|
| 423 |
+
- `examples/cogvideox_fun/predict_v2v.py`ファイルで`validation_video`、`validation_image_end`、`prompt`、`neg_prompt`、`guidance_scale`、`seed`を変更します。
|
| 424 |
+
- `validation_video`はビデオ生成のための参照ビデオです。以下のデモビデオを使用して実行できます:[デモビデオ](https://pai-aigc-photog.oss-cn-hangzhou.aliyuncs.com/cogvideox_fun/asset/v1/play_guitar.mp4)
|
| 425 |
+
- 次に、`examples/cogvideox_fun/predict_v2v.py`ファイルを実行し、結果が生成されるのを待ちます。結果は`samples/cogvideox-fun-videos_v2v`フォルダに保存されます。
|
| 426 |
+
- 通常の制御付きビデオ生成(Canny、Pose、Depthなど):
|
| 427 |
+
- `examples/cogvideox_fun/predict_v2v_control.py`ファイルで`control_video`、`validation_image_end`、`prompt`、`neg_prompt`、`guidance_scale`、`seed`を変更します。
|
| 428 |
+
- `control_video`は、Canny、Pose、Depthなどの演算子で抽出された制御用ビデオです。以下のデモビデオを使用して実行できます:[デモビデオ](https://pai-aigc-photog.oss-cn-hangzhou.aliyuncs.com/cogvideox_fun/asset/v1.1/pose.mp4)
|
| 429 |
+
- 次に、`examples/cogvideox_fun/predict_v2v_control.py`ファイルを実行し、結果が生成されるのを待ちます。結果は`samples/cogvideox-fun-videos_v2v_control`フォルダに保存されます。
|
| 430 |
+
- ステップ3: 自分でトレーニングした他のバックボーンやLoraを組み合わせたい場合は、必要に応じて`examples/{model_name}/predict_t2v.py`や`examples/{model_name}/predict_i2v.py`、`lora_path`を修正します。
|
| 431 |
+
|
| 432 |
+
##### ii. 複数GPUでの推論:
|
| 433 |
+
多カードでの推論を行う際は、xfuserリポジトリのインストールに注意してください。xfuser==0.4.2 と yunchang==0.6.2 のインストールが推奨されます。
|
| 434 |
+
```
|
| 435 |
+
pip install xfuser==0.4.2 --progress-bar off -i https://mirrors.aliyun.com/pypi/simple/
|
| 436 |
+
pip install yunchang==0.6.2 --progress-bar off -i https://mirrors.aliyun.com/pypi/simple/
|
| 437 |
+
```
|
| 438 |
+
|
| 439 |
+
`ulysses_degree` と `ring_degree` の積が使用する GPU 数と一致することを確認してください。たとえば、8つのGPUを使用する場合、`ulysses_degree=2` と `ring_degree=4`、または `ulysses_degree=4` と `ring_degree=2` を設定することができます。
|
| 440 |
+
|
| 441 |
+
- `ulysses_degree` はヘッド(head)に分割した後の並列化を行います。
|
| 442 |
+
- `ring_degree` はシーケンスに分割した後の並列化を行います。
|
| 443 |
+
|
| 444 |
+
`ring_degree` は `ulysses_degree` よりも通信コストが高いため、これらのパラメータを設定する際には、シーケンス長とモデルのヘッド数を考慮する必要があります。
|
| 445 |
+
|
| 446 |
+
8GPUでの並列推論を例に挙げます:
|
| 447 |
+
|
| 448 |
+
- **Wan2.1-Fun-V1.1-14B-InP** はヘッド数が40あります。この場合、`ulysses_degree` は40で割り切れる値(例:2, 4, 8など)に設定する必要があります。したがって、8GPUを使用して並列推論を行う場合、`ulysses_degree=8` と `ring_degree=1` を設定できます。
|
| 449 |
+
|
| 450 |
+
- **Wan2.1-Fun-V1.1-1.3B-InP** はヘッド数が12あります。この場合、`ulysses_degree` は12で割り切れる値(例:2, 4など)に設定する必要があります。したがって、8GPUを使用して並列推論を行う場合、`ulysses_degree=4` と `ring_degree=2` を設定できます。
|
| 451 |
+
|
| 452 |
+
パラメータの設定が完了したら、以下のコマンドで並列推論を実行してください:
|
| 453 |
+
|
| 454 |
+
```sh
|
| 455 |
+
torchrun --nproc-per-node=8 examples/wan2.1_fun/predict_t2v.py
|
| 456 |
+
```
|
| 457 |
+
|
| 458 |
+
#### d. UIインターフェースを使用する
|
| 459 |
+
|
| 460 |
+
WebUIは、テキストからビデオ、画像からビデオ、ビデオからビデオ、および通常の制御付きビデオ生成(Canny、Pose、Depthなど)をサポートします。現在、このライブラリはCogVideoX-Fun、Wan2.1、およびWan2.1-Funをサポートしており、`examples`フォルダ内のフォルダ名で区別されています。異なるモデルがサポートする機能が異なるため、状況に応じて区別してください。以下はCogVideoX-Funを例として説明します。
|
| 461 |
+
|
| 462 |
+
- ステップ1: 対応する[重み](#model-zoo)をダウンロードし、`models`フォルダに配置します。
|
| 463 |
+
- ステップ2: `examples/cogvideox_fun/app.py`ファイルを実行し、Gradioページに入ります。
|
| 464 |
+
- ステップ3: ペ��ジ上で生成モデルを選択し、`prompt`、`neg_prompt`、`guidance_scale`、`seed`などを入力し、「生成」をクリックして結果が生成されるのを待ちます。結果は`sample`フォルダに保存されます。
|
| 465 |
+
|
| 466 |
+
### 2. モデルのトレーニング
|
| 467 |
+
完全なモデルトレーニングの流れには、データの前処理とVideo DiTのトレーニングが含まれるべきです。異なるモデルのトレーニングプロセスは類似しており、データ形式も類似しています:
|
| 468 |
+
|
| 469 |
+
<h4 id="data-preprocess">a. データ前処理</h4>
|
| 470 |
+
|
| 471 |
+
画像データを使用してLoraモデルをトレーニングする簡単なデモを提供しました。詳細は[wiki](https://github.com/aigc-apps/CogVideoX-Fun/wiki/Training-Lora)をご覧ください。
|
| 472 |
+
|
| 473 |
+
長いビデオのセグメンテーション、クリーニング、説明のための完全なデータ前処理リンクは、ビデオキャプションセクションの[README](cogvideox/video_caption/README.md)を参照してください。
|
| 474 |
+
|
| 475 |
+
テキストから画像およびビデオ生成モデルをトレーニングしたい場合。この形式でデータセットを配置する必要があります。
|
| 476 |
+
|
| 477 |
+
```
|
| 478 |
+
📦 project/
|
| 479 |
+
├── 📂 datasets/
|
| 480 |
+
│ ├── 📂 internal_datasets/
|
| 481 |
+
│ ├── 📂 train/
|
| 482 |
+
│ │ ├── 📄 00000001.mp4
|
| 483 |
+
│ │ ├── 📄 00000002.jpg
|
| 484 |
+
│ │ └── 📄 .....
|
| 485 |
+
│ └── 📄 json_of_internal_datasets.json
|
| 486 |
+
```
|
| 487 |
+
|
| 488 |
+
json_of_internal_datasets.jsonは標準のJSONファイルです。json内のfile_pathは相対パスとして設定できます。以下のように:
|
| 489 |
+
```json
|
| 490 |
+
[
|
| 491 |
+
{
|
| 492 |
+
"file_path": "train/00000001.mp4",
|
| 493 |
+
"text": "スーツとサングラスを着た若い男性のグループが街の通りを歩いている。",
|
| 494 |
+
"type": "video"
|
| 495 |
+
},
|
| 496 |
+
{
|
| 497 |
+
"file_path": "train/00000002.jpg",
|
| 498 |
+
"text": "スーツとサングラスを着た若い男性のグループが街の通りを歩いている。",
|
| 499 |
+
"type": "image"
|
| 500 |
+
},
|
| 501 |
+
.....
|
| 502 |
+
]
|
| 503 |
+
```
|
| 504 |
+
|
| 505 |
+
次のように絶対パスとして設定することもできます:
|
| 506 |
+
```json
|
| 507 |
+
[
|
| 508 |
+
{
|
| 509 |
+
"file_path": "/mnt/data/videos/00000001.mp4",
|
| 510 |
+
"text": "スーツとサングラスを着た若い男性のグループが街の通りを歩いている。",
|
| 511 |
+
"type": "video"
|
| 512 |
+
},
|
| 513 |
+
{
|
| 514 |
+
"file_path": "/mnt/data/train/00000001.jpg",
|
| 515 |
+
"text": "スーツとサングラスを着た若い男性のグループが街の通りを歩いている。",
|
| 516 |
+
"type": "image"
|
| 517 |
+
},
|
| 518 |
+
.....
|
| 519 |
+
]
|
| 520 |
+
```
|
| 521 |
+
|
| 522 |
+
<h4 id="dit-train">b. Video DiTトレーニング </h4>
|
| 523 |
+
|
| 524 |
+
データ前処理時にデータ形式が相対パスの場合、```scripts/{model_name}/train.sh```を次のように設定します。
|
| 525 |
+
```
|
| 526 |
+
export DATASET_NAME="datasets/internal_datasets/"
|
| 527 |
+
export DATASET_META_NAME="datasets/internal_datasets/json_of_internal_datasets.json"
|
| 528 |
+
```
|
| 529 |
+
|
| 530 |
+
データ形式が絶対パスの場合、```scripts/train.sh```を次のように設定します。
|
| 531 |
+
```
|
| 532 |
+
export DATASET_NAME=""
|
| 533 |
+
export DATASET_META_NAME="/mnt/data/json_of_internal_datasets.json"
|
| 534 |
+
```
|
| 535 |
+
|
| 536 |
+
次に、scripts/train.shを実行します。
|
| 537 |
+
```sh
|
| 538 |
+
sh scripts/train.sh
|
| 539 |
+
```
|
| 540 |
+
いくつかのパラメータ設定の詳細について:
|
| 541 |
+
Wan2.1-Funは[Readme Train](scripts/wan2.1_fun/README_TRAIN.md)と[Readme Lora](scripts/wan2.1_fun/README_TRAIN_LORA.md)を参照してください。
|
| 542 |
+
Wan2.1は[Readme Train](scripts/wan2.1/README_TRAIN.md)と[Readme Lora](scripts/wan2.1/README_TRAIN_LORA.md)を参照してください。
|
| 543 |
+
CogVideoX-Funは[Readme Train](scripts/cogvideox_fun/README_TRAIN.md)と[Readme Lora](scripts/cogvideox_fun/README_TRAIN_LORA.md)を参照してください。
|
| 544 |
+
|
| 545 |
+
# モデルの場所
|
| 546 |
+
|
| 547 |
+
## 1. Wan2.2-Fun
|
| 548 |
+
|
| 549 |
+
| 名前 | ストレージ容量 | Hugging Face | Model Scope | 説明 |
|
| 550 |
+
|------|----------------|------------|-------------|------|
|
| 551 |
+
| Wan2.2-Fun-A14B-InP | 64.0 GB | [🤗Link](https://huggingface.co/alibaba-pai/Wan2.2-Fun-A14B-InP) | [😄Link](https://modelscope.cn/models/PAI/Wan2.2-Fun-A14B-InP) | Wan2.2-Fun-14Bのテキスト・画像から動画を生成するモデルの重み。複数の解像度で学習されており、動画の最初と最後のフレームの予測をサポートしています。 |
|
| 552 |
+
| Wan2.2-Fun-A14B-Control | 64.0 GB | [🤗Link](https://huggingface.co/alibaba-pai/Wan2.2-Fun-A14B-Control) | [😄Link](https://modelscope.cn/models/PAI/Wan2.2-Fun-A14B-Control) | Wan2.2-Fun-14Bの動画制御用重み。Canny、Depth、Pose、MLSDなどのさまざまな制御条件に対応しており、軌跡制御もサポートしています。512、768、1024の複数解像度での動画生成が可能で、81フレーム、16fpsで学習されています。多言語対応の予測もサポートしています。 |
|
| 553 |
+
| Wan2.2-Fun-A14B-Contro-Camera | 64.0 GB | [🤗リンク](https://huggingface.co/alibaba-pai/Wan2.2-Fun-A14B-Control-Camera) | [😄リンク](https://modelscope.cn/models/PAI/Wan2.2-Fun-A14B-Control-Camera)| Wan2.2-Fun-14Bのカメラレンズ制御重み。512、768、1024のマルチ解像度での動画予測をサポートし、81フレーム、毎秒16フレームで訓練されています。多言語予測に対応しています。 |
|
| 554 |
+
| Wan2.2-Fun-5B-InP | 23.0 GB | [🤗Link](https://huggingface.co/alibaba-pai/Wan2.2-Fun-5B-InP) | [😄Link](https://modelscope.cn/models/PAI/Wan2.2-Fun-5B-InP) | Wan2.2-Fun-5B テキストから動画生成用の重み。121フレーム、24 FPSで学習され、先頭/末尾フレーム予測をサポート。 |
|
| 555 |
+
| Wan2.2-Fun-5B-Control | 23.0 GB | [🤗Link](https://huggingface.co/alibaba-pai/Wan2.2-Fun-5B-Control) | [😄Link](https://modelscope.cn/models/PAI/Wan2.2-Fun-5B-Control)| Wan2.2-Fun-5B 動画制御用重み。Canny、Depth、Pose、MLSDなどの制御条件や軌道制御をサポート。121フレーム、24 FPSで学習され、多言語予測に対応。 |
|
| 556 |
+
| Wan2.2-Fun-5B-Control-Camera | 23.0 GB | [🤗Link](https://huggingface.co/alibaba-pai/Wan2.2-Fun-5B-Control-Camera) | [😄Link](https://modelscope.cn/models/PAI/Wan2.2-Fun-5B-Control-Camera)| Wan2.2-Fun-5B カメラレンズ制御用重み。121フレーム、24 FPSで学習され、多言語予測に対応。 |
|
| 557 |
+
|
| 558 |
+
## 2. Wan2.2
|
| 559 |
+
|
| 560 |
+
| モデル名 | Hugging Face | Model Scope | 説明 |
|
| 561 |
+
|--|--|--|--|
|
| 562 |
+
| Wan2.2-TI2V-5B | [🤗リンク](https://huggingface.co/Wan-AI/Wan2.2-TI2V-5B) | [😄リンク](https://www.modelscope.cn/models/Wan-AI/Wan2.2-TI2V-5B) | 万象2.2-5B テキストから動画生成重み |
|
| 563 |
+
| Wan2.2-T2V-A14B | [🤗リンク](https://huggingface.co/Wan-AI/Wan2.2-T2V-A14B) | [😄リンク](https://www.modelscope.cn/models/Wan-AI/Wan2.2-T2V-A14B) | 万象2.2-14B テキストから動画生成重み |
|
| 564 |
+
| Wan2.2-I2V-A14B | [🤗リンク](https://huggingface.co/Wan-AI/Wan2.2-I2V-A14B) | [😄リンク](https://www.modelscope.cn/models/Wan-AI/Wan2.2-I2V-A14B) | 万象2.2-14B 画像から動画生成重み |
|
| 565 |
+
|
| 566 |
+
## 3. Wan2.1-Fun
|
| 567 |
+
|
| 568 |
+
V1.1:
|
| 569 |
+
| 名称 | ストレージ容量 | Hugging Face | Model Scope | 説明 |
|
| 570 |
+
|--|--|--|--|--|
|
| 571 |
+
| Wan2.1-Fun-V1.1-1.3B-InP | 19.0 GB | [🤗リンク](https://huggingface.co/alibaba-pai/Wan2.1-Fun-V1.1-1.3B-InP) | [😄リンク](https://modelscope.cn/models/PAI/Wan2.1-Fun-V1.1-1.3B-InP) | Wan2.1-Fun-V1.1-1.3Bのテキスト・画像から動画生成の重み。マルチ解像度で訓練され、最初と最後の画像予測をサポートします。 |
|
| 572 |
+
| Wan2.1-Fun-V1.1-14B-InP | 47.0 GB | [🤗リンク](https://huggingface.co/alibaba-pai/Wan2.1-Fun-V1.1-14B-InP) | [😄リンク](https://modelscope.cn/models/PAI/Wan2.1-Fun-V1.1-14B-InP) | Wan2.1-Fun-V1.1-14Bのテキスト・画像から動画生成の重み。マルチ解像度で訓練され、最初と最後の画像予測をサポートします。 |
|
| 573 |
+
| Wan2.1-Fun-V1.1-1.3B-Control | 19.0 GB | [🤗リンク](https://huggingface.co/alibaba-pai/Wan2.1-Fun-V1.1-1.3B-Control) | [😄リンク](https://modelscope.cn/models/PAI/Wan2.1-Fun-V1.1-1.3B-Control)| Wan2.1-Fun-V1.1-1.3Bのビデオ制御重み。Canny、Depth、Pose、MLSDなどの異なる制御条件に対応し、参照画像+制御条件を使用した制御や軌跡制御をサポートします。512、768、1024のマルチ解像度での動画予測をサポートし、81フレーム、毎秒16フレームで訓練されています。多言語予測に対応しています。 |
|
| 574 |
+
| Wan2.1-Fun-V1.1-14B-Control | 47.0 GB | [🤗リンク](https://huggingface.co/alibaba-pai/Wan2.1-Fun-V1.1-14B-Control) | [😄リンク](https://modelscope.cn/models/PAI/Wan2.1-Fun-V1.1-14B-Control)| Wan2.1-Fun-V1.1-14Bのビデオ制御重み。Canny、Depth、Pose、MLSDなどの異なる制御条件に対応し、参照画像+制御条件を使用した制御や軌跡制御をサポートします。512、768、1024のマルチ解像度での動画予測をサポートし、81フレーム、毎秒16フレームで訓練されています。多言語予測に対応しています。 |
|
| 575 |
+
| Wan2.1-Fun-V1.1-1.3B-Control-Camera | 19.0 GB | [🤗リンク](https://huggingface.co/alibaba-pai/Wan2.1-Fun-V1.1-1.3B-Control-Camera) | [😄リンク](https://modelscope.cn/models/PAI/Wan2.1-Fun-V1.1-1.3B-Control-Camera)| Wan2.1-Fun-V1.1-1.3Bのカメラレンズ制御重み。512、768、1024のマルチ解像度での動画予測をサポートし、81フレーム、毎秒16フレームで訓練されています。多言語予測に対応しています。 |
|
| 576 |
+
| Wan2.1-Fun-V1.1-14B-Control-Camera | 47.0 GB | [🤗リンク](https://huggingface.co/alibaba-pai/Wan2.1-Fun-V1.1-14B-Control-Camera) | [😄リンク](https://modelscope.cn/models/PAI/Wan2.1-Fun-V1.1-14B-Control-Camera)| Wan2.1-Fun-V1.1-14Bのカメラレンズ制御重み。512、768、1024のマルチ解像度での動画予測をサポートし、81フレーム、毎秒16フレームで訓練されています。多言語予測に対応しています。 |
|
| 577 |
+
|
| 578 |
+
|
| 579 |
+
V1.0:
|
| 580 |
+
| 名称 | ストレージ容量 | Hugging Face | Model Scope | 説明 |
|
| 581 |
+
|--|--|--|--|--|
|
| 582 |
+
| Wan2.1-Fun-1.3B-InP | 19.0 GB | [🤗Link](https://huggingface.co/alibaba-pai/Wan2.1-Fun-1.3B-InP) | [😄Link](https://modelscope.cn/models/PAI/Wan2.1-Fun-1.3B-InP) | Wan2.1-Fun-1.3Bのテキスト・画像から動画生成する重み。マルチ解像度で学習され、開始・終了画像予測をサポート。 |
|
| 583 |
+
| Wan2.1-Fun-14B-InP | 47.0 GB | [🤗Link](https://huggingface.co/alibaba-pai/Wan2.1-Fun-14B-InP) | [😄Link](https://modelscope.cn/models/PAI/Wan2.1-Fun-14B-InP) | Wan2.1-Fun-14Bのテキスト・画像から動画生成する重み。マルチ解像度で学習され、開始・終了画像予測をサポート。 |
|
| 584 |
+
| Wan2.1-Fun-1.3B-Control | 19.0 GB | [🤗Link](https://huggingface.co/alibaba-pai/Wan2.1-Fun-1.3B-Control) | [😄Link](https://modelscope.cn/models/PAI/Wan2.1-Fun-1.3B-Control) | Wan2.1-Fun-1.3Bのビデオ制御ウェイト。Canny、Depth、Pose、MLSDなどの異なる制御条件をサポートし、トラジェクトリ制御も利用可能。512、768、1024のマルチ解像度でのビデオ予測をサポートし、81フレーム(1秒間に16フレーム)でトレーニング済みで、多言語予測にも対応しています。 |
|
| 585 |
+
| Wan2.1-Fun-14B-Control | 47.0 GB | [🤗Link](https://huggingface.co/alibaba-pai/Wan2.1-Fun-14B-Control) | [😄Link](https://modelscope.cn/models/PAI/Wan2.1-Fun-14B-Control) | Wan2.1-Fun-14Bのビデオ制御ウェイト。Canny、Depth、Pose、MLSDなどの異なる制御条件をサポートし、トラジェクトリ制御も利用可能。512、768、1024のマルチ解像度でのビデオ予測をサポートし、81フレーム(1秒間に16フレーム)でトレーニング済みで、多言語予測にも対応しています。 |
|
| 586 |
+
|
| 587 |
+
## 4. Wan2.1
|
| 588 |
+
|
| 589 |
+
| 名称 | Hugging Face | Model Scope | 説明 |
|
| 590 |
+
|--|--|--|--|
|
| 591 |
+
| Wan2.1-T2V-1.3B | [🤗Link](https://huggingface.co/Wan-AI/Wan2.1-T2V-1.3B) | [😄Link](https://www.modelscope.cn/models/Wan-AI/Wan2.1-T2V-1.3B) | 万象2.1-1.3Bのテキストから動画生成する重み |
|
| 592 |
+
| Wan2.1-T2V-14B | [🤗Link](https://huggingface.co/Wan-AI/Wan2.1-T2V-14B) | [😄Link](https://www.modelscope.cn/models/Wan-AI/Wan2.1-T2V-14B) | 万象2.1-14Bのテキストから動画生成する重み |
|
| 593 |
+
| Wan2.1-I2V-14B-480P | [🤗Link](https://huggingface.co/Wan-AI/Wan2.1-I2V-14B-480P) | [😄Link](https://www.modelscope.cn/models/Wan-AI/Wan2.1-I2V-14B-480P) | 万象2.1-14B-480Pの画像から動画生成する重み |
|
| 594 |
+
| Wan2.1-I2V-14B-720P| [🤗Link](https://huggingface.co/Wan-AI/Wan2.1-I2V-14B-720P) | [😄Link](https://www.modelscope.cn/models/Wan-AI/Wan2.1-I2V-14B-720P) | 万象2.1-14B-720Pの画像から動画生成する重み |
|
| 595 |
+
|
| 596 |
+
## 5. CogVideoX-Fun
|
| 597 |
+
|
| 598 |
+
V1.5:
|
| 599 |
+
|
| 600 |
+
| 名称 | ストレージスペース | Hugging Face | Model Scope | 説明 |
|
| 601 |
+
|--|--|--|--|--|
|
| 602 |
+
| CogVideoX-Fun-V1.5-5b-InP | 20.0 GB | [🤗Link](https://huggingface.co/alibaba-pai/CogVideoX-Fun-V1.5-5b-InP) | [😄Link](https://modelscope.cn/models/PAI/CogVideoX-Fun-V1.5-5b-InP) | 公式のグラフ生成ビデオモデルは、複数の解像度(512、768、1024)でビデオを予測できます。85フレーム、8フレーム/秒でトレーニングされています。 |
|
| 603 |
+
| CogVideoX-Fun-V1.5-Reward-LoRAs | - | [🤗リンク](https://huggingface.co/alibaba-pai/CogVideoX-Fun-V1.1-Reward-LoRAs) | [😄リンク](https://modelscope.cn/models/PAI/CogVideoX-Fun-V1.5-Reward-LoRAs) | 公式の報酬逆伝播技術モデルで、CogVideoX-Fun-V1.5が生成するビデオを最適化し、人間の嗜好によりよく合うようにする。 |
|
| 604 |
+
|
| 605 |
+
V1.1:
|
| 606 |
+
|
| 607 |
+
| 名称 | ストレージスペース | Hugging Face | Model Scope | 説明 |
|
| 608 |
+
|--|--|--|--|--|
|
| 609 |
+
| CogVideoX-Fun-V1.1-2b-InP | 13.0 GB | [🤗リンク](https://huggingface.co/alibaba-pai/CogVideoX-Fun-V1.1-2b-InP) | [😄リンク](https://modelscope.cn/models/PAI/CogVideoX-Fun-V1.1-2b-InP) | 公式のグラフ生成ビデオモデルは、複数の解像度(512、768、1024、1280)でビデオを予測できます。49フレーム、8フレーム/秒でトレーニングされています。参照画像にノイズが追加され、V1.0と比較して動きの幅が広がっています。 |
|
| 610 |
+
| CogVideoX-Fun-V1.1-5b-InP | 20.0 GB | [🤗リンク](https://huggingface.co/alibaba-pai/CogVideoX-Fun-V1.1-5b-InP) | [😄リンク](https://modelscope.cn/models/PAI/CogVideoX-Fun-V1.1-5b-InP) | 公式のグラフ生成ビデオモデルは、複数の解像度(512、768、1024、1280)でビデオを予測できます。49フレーム、8フレーム/秒でトレーニングされています。参照画像にノイズが追加され、V1.0と比較して動きの幅が広がっています。 |
|
| 611 |
+
| CogVideoX-Fun-V1.1-2b-Pose | 13.0 GB | [🤗リンク](https://huggingface.co/alibaba-pai/CogVideoX-Fun-V1.1-2b-Pose) | [😄リンク](https://modelscope.cn/models/PAI/CogVideoX-Fun-V1.1-2b-Pose) | 公式のポーズコントロールビデオモデルは、複数の解像度(512、768、1024、1280)でビデオを予測できます。49フレーム、8フレーム/秒でトレーニングされています。|
|
| 612 |
+
| CogVideoX-Fun-V1.1-2b-Control | 13.0 GB | [🤗Link](https://huggingface.co/alibaba-pai/CogVideoX-Fun-V1.1-2b-Control) | [😄Link](https://modelscope.cn/models/PAI/CogVideoX-Fun-V1.1-2b-Control) | 公式のコントロールビデオモデルは、複数の解像度(512、768、1024、1280)でビデオを予測できます。49フレーム、8フレーム/秒でトレーニングされています。Canny、Depth、Pose、MLSDなどのさまざまなコントロール条件をサポートします。|
|
| 613 |
+
| CogVideoX-Fun-V1.1-5b-Pose | 20.0 GB | [🤗リンク](https://huggingface.co/alibaba-pai/CogVideoX-Fun-V1.1-5b-Pose) | [😄リンク](https://modelscope.cn/models/PAI/CogVideoX-Fun-V1.1-5b-Pose) | 公式のポーズコントロールビデオモデルは、複数の解像度(512、768、1024、1280)でビデオを予測できます。49フレーム、8フレーム/秒でトレーニングされています。|
|
| 614 |
+
| CogVideoX-Fun-V1.1-5b-Control | 20.0 GB | [🤗リンク](https://huggingface.co/alibaba-pai/CogVideoX-Fun-V1.1-5b-Control) | [😄リンク](https://modelscope.cn/models/PAI/CogVideoX-Fun-V1.1-5b-Control) | 公式のコントロールビデオモデルは、複数の解像度(512、768、1024、1280)でビデオを予測できます。49フレーム、8フレーム/秒でトレーニングされています。Canny、Depth、Pose、MLSDなどのさまざまなコントロール条件をサポートします。|
|
| 615 |
+
| CogVideoX-Fun-V1.1-Reward-LoRAs | - | [🤗リンク](https://huggingface.co/alibaba-pai/CogVideoX-Fun-V1.1-Reward-LoRAs) | [😄リンク](https://modelscope.cn/models/PAI/CogVideoX-Fun-V1.5-Reward-LoRAs) | 公式の報酬逆伝播技術モデルで、CogVideoX-Fun-V1.1が生成するビデオを最適化し、人間の嗜好によりよく合うようにする。 |
|
| 616 |
+
|
| 617 |
+
<details>
|
| 618 |
+
<summary>(Obsolete) V1.0:</summary>
|
| 619 |
+
|
| 620 |
+
| 名称 | ストレージスペース | Hugging Face | Model Scope | 説明 |
|
| 621 |
+
|--|--|--|--|--|
|
| 622 |
+
| CogVideoX-Fun-2b-InP | 13.0 GB | [🤗リンク](https://huggingface.co/alibaba-pai/CogVideoX-Fun-2b-InP) | [😄リンク](https://modelscope.cn/models/PAI/CogVideoX-Fun-2b-InP) | 公式のグラフ生成ビデオモデルは、複数の解像度(512、768、1024、1280)でビデオを予測できます。49フレーム、8フレーム/秒でトレーニングされています。 |
|
| 623 |
+
| CogVideoX-Fun-5b-InP | 20.0 GB | [🤗リンク](https://huggingface.co/alibaba-pai/CogVideoX-Fun-5b-InP)| [😄リンク](https://modelscope.cn/models/PAI/CogVideoX-Fun-5b-InP)| 公式のグラフ生成ビデオモデルは、複数の解像度(512、768、1024、1280)でビデオを予測できます。49フレーム、8フレーム/秒でトレーニングされています。|
|
| 624 |
+
</details>
|
| 625 |
+
|
| 626 |
+
# TODOリスト
|
| 627 |
+
- 日本語をサポート。
|
| 628 |
+
|
| 629 |
+
# 参考文献
|
| 630 |
+
- CogVideo: https://github.com/THUDM/CogVideo/
|
| 631 |
+
- EasyAnimate: https://github.com/aigc-apps/EasyAnimate
|
| 632 |
+
- Wan2.1: https://github.com/Wan-Video/Wan2.1/
|
| 633 |
+
- Wan2.2: https://github.com/Wan-Video/Wan2.2/
|
| 634 |
+
|
| 635 |
+
# ライセンス
|
| 636 |
+
このプロジェクトは[Apache License (Version 2.0)](https://github.com/modelscope/modelscope/blob/master/LICENSE)の下でライセンスされています。
|
| 637 |
+
|
| 638 |
+
CogVideoX-2Bモデル(対応するTransformersモジュール、VAEモジュールを含む)は、[Apache 2.0ライセンス](LICENSE)の下でリリースされています。
|
| 639 |
+
|
| 640 |
+
CogVideoX-5Bモデル(Transformersモジュール)は、[CogVideoXライセンス](https://huggingface.co/THUDM/CogVideoX-5b/blob/main/LICENSE)の下でリリースされています。
|